
Einen MCP-Server für Laborgeräte auf Basis von Hersteller-SDKs entwickeln - 4 Erkenntnisse aus LiquidBridge
Einen MCP-Server für Laborgeräte auf Basis von Hersteller-SDKs entwickeln - 4 Erkenntnisse aus LiquidBridge
Einen MCP-Server für Laborgeräte auf Basis eines Hersteller-SDK zu entwickeln, funktioniert - allerdings nur, wenn der Server das SDK als feindliche Abhängigkeit behandelt. In 18 Monaten Entwicklung von LiquidBridge, unserem digitalen Zwilling und unserer MCP-Schicht für Liquid Handler, haben vier Muster den Unterschied zwischen einem fragilen Wrapper und einem produktionsreifen Server ausgemacht: eine harte Adaptergrenze, Validierung vor dem Tool-Aufruf, asynchrone Ereigniskanäle für lang laufende Befehle und eine vollständige Plansimulation vor jeder physischen Bewegung. Dieser Beitrag erläutert jedes Muster anhand des Codes, der Fehlerbilder, die es notwendig gemacht haben, und dessen, was wir beim nächsten Mal anders machen würden.
Warum sich Hersteller-SDKs nicht sauber auf MCP abbilden lassen
Hersteller-SDKs für Liquid Handler wurden nicht dafür entwickelt, KI-Agenten zugänglich gemacht zu werden. Sie wurden für Protokollautoren entwickelt, die Skripte in einer Hersteller-IDE schreiben.
Diese Diskrepanz zeigt sich auf drei vorhersehbare Arten:
Zustandsbehaftet statt zustandslos. Die meisten Hersteller-SDKs setzen eine lang laufende Sitzung voraus. Sie initialisieren ein Deck, belegen Ressourcen, führen Schritte aus und bauen alles wieder ab. Ein MCP-tools/call ist hingegen eine zustandslose Anfrage. Um das eine auf das andere abzubilden, muss der Server den Sitzungslebenszyklus im Namen des Agenten verwalten.
APIs, bei denen Nebenwirkungen an erster Stelle stehen. SDK-Methoden wie pipette.aspirate(volume, well) bewegen beim Aufruf physische Hardware. Werden sie direkt als MCP-Tools bereitgestellt, kann ein einziges halluziniertes Argument einen mehrtägigen Zellkulturlauf verderben, Reagenzien unbrauchbar machen, deren Herstellung Wochen gedauert hat, oder einen schweren mechanischen Fehler an einem Gerät im sechsstelligen Preisbereich auslösen. Bei Laborhardware steht weit mehr auf dem Spiel als bei einer Shell.
Vom Hersteller definierte Fehlersemantik. Ein Hamilton-VENUS-Fehlercode, eine Trace-Exception von Tecan Fluent Control und eine Python-Exception von PyLabRobot haben nichts gemeinsam, ausser dass etwas schiefgelaufen ist. Ein KI-Agent benötigt einen einheitlichen Fehlervertrag - strukturiert, mit Angabe, ob ein erneuter Versuch möglich ist, und mit einer Handlungsempfehlung -, sonst wiederholt er Aufrufe auf destruktive Weise oder eskaliert alles an einen Menschen.
Die vier nachfolgenden Muster adressieren diese Diskrepanzen direkt.
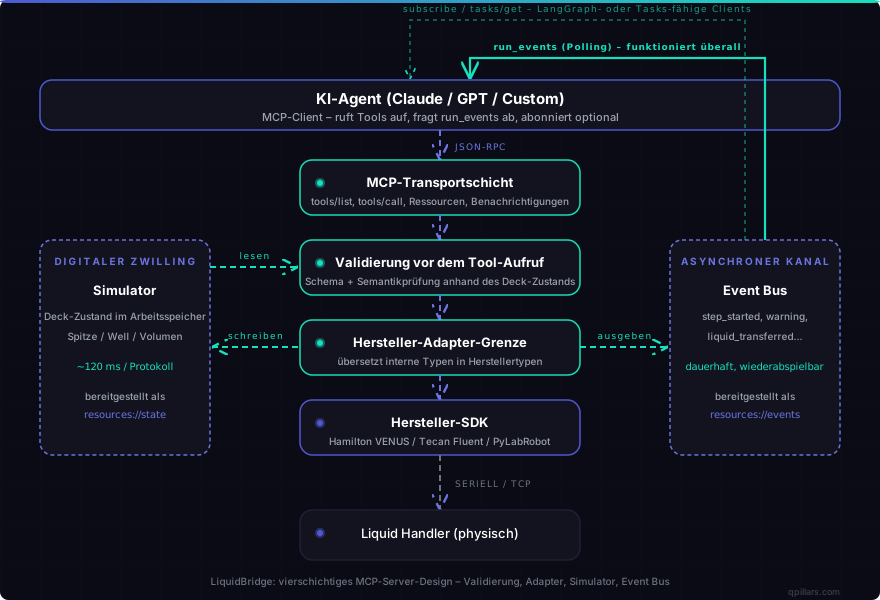
Das Diagramm zeigt die vier Schichten, auf die wir uns schliesslich festgelegt haben. Der MCP-Transport kommuniziert über JSON-RPC mit dem Agenten. Die Validierungsschicht weist fehlerhafte oder unsichere Aufrufe zurück, bevor sie das SDK erreichen. Der Herstelleradapter ist der einzige Code, der mit Herstellertypen in Berührung kommt. Der Event-Bus und das Simulations-Backend laufen parallel und sind als MCP-Ressourcen adressierbar, nicht nur als Rückgabewerte von Tools.
Muster 1 - Die Grenze des Herstelleradapters
Die erste Erkenntnis: Halten Sie das Hersteller-SDK aus allen anderen Schichten heraus.
In LiquidBridge importiert genau ein Modul das Hersteller-SDK. Alles andere - Tool-Handler, Validatoren, der Simulator, der Event-Bus - verwendet unsere internen Typen: Volume, WellAddress, TipBoxLayout, PipetteOperation. Herstellertypen enden am Adapter.
Die Struktur ist bewusst unspektakulär:
# liquidbridge/adapters/base.py
from abc import ABC, abstractmethod
from liquidbridge.types import (
    Volume, WellAddress, PipetteOperation, OperationResult, DeckLayout
)

class LiquidHandlerAdapter(ABC):
    """The only contract the rest of the codebase depends on."""

    @abstractmethod
    async def load_deck(self, layout: DeckLayout) -> None: ...

    @abstractmethod
    async def aspirate(self, op: PipetteOperation) -> OperationResult: ...

    @abstractmethod
    async def dispense(self, op: PipetteOperation) -> OperationResult: ...

    @abstractmethod
    async def tip_pickup(self, channel: int, tip_address: WellAddress) -> OperationResult: ...

    @abstractmethod
    async def get_state(self) -> dict: ...
Ein konkreter Adapter für ein Deck der Hamilton-Klasse sieht so aus. Beachten Sie, dass die Herstellerimporte auf diese Datei beschränkt sind und jede Hersteller-Exception übersetzt wird:
# liquidbridge/adapters/hamilton_adapter.py
from liquidbridge.types import PipetteOperation, OperationResult, Volume
from liquidbridge.adapters.base import LiquidHandlerAdapter
from liquidbridge.errors import (
    HardwareTimeout, DeckCollision, OutOfTips, AdapterFault,
)

# Vendor import lives ONLY here. Replace with the real SDK module name.
from vendor_sdk import LiquidHandler as VendorHandler  # type: ignore
from vendor_sdk.errors import (
    VendorTimeoutError, VendorCollisionError,
    VendorTipError, VendorGenericError,
)

class HamiltonAdapter(LiquidHandlerAdapter):
    def __init__(self, handler: VendorHandler):
        self._h = handler

    async def aspirate(self, op: PipetteOperation) -> OperationResult:
        try:
            await self._h.pipette(
                channel=op.channel,
                well=str(op.well),  # vendor wants strings like "A1"
                volume_ul=op.volume.as_microliters(),
                liquid_class=op.liquid_class,
                mode="aspirate",
            )
            return OperationResult.ok(operation_id=op.id)
        except VendorTimeoutError as e:
            raise HardwareTimeout(op.id, str(e)) from e
        except VendorCollisionError as e:
            raise DeckCollision(op.id, str(e)) from e
        except VendorTipError as e:
            raise OutOfTips(op.id, str(e)) from e
        except VendorGenericError as e:
            raise AdapterFault(op.id, str(e)) from e
Der Nutzen zeigt sich an dem Tag, an dem ein Kunde fragt: «Können Sie auch ein Tecan Fluent unterstützen?» Das Hinzufügen von FluentAdapter betrifft eine einzige Datei. Der MCP-Server, die Validatoren, der Simulator und der Event-Bus bleiben unverändert.
Es handelt sich um dasselbe Trennungsmuster, das PyLabRobot - die quelloffene, hardwareunabhängige Liquid-Handling-Bibliothek - mit ihrer Backend-Abstraktion verwendet, und es ist der Grund, weshalb PyLabRobot Hamilton STAR, Opentrons und Tecan über eine einzige benutzerseitige API ansprechen kann. Wenn Sie einen MCP-Server für Laborgeräte entwickeln, übernehmen Sie diese Grenze, auch wenn Sie mit nur einem Hersteller beginnen. Früher oder später werden es zwei sein.
Muster 2 - Validierung vor dem Tool-Aufruf
Die zweite Erkenntnis: Günstige, deterministische Prüfungen müssen erfolgen, bevor der Aufruf das SDK erreicht.
MCP liefert Ihnen die JSON-Schema-Validierung der Tool-Eingaben kostenlos mit. Damit werden Typfehler und Skalarwerte ausserhalb des zulässigen Bereichs abgedeckt. Nicht abgedeckt werden hingegen die laborspezifischen Fehlerbilder, die Protokolle tatsächlich scheitern lassen:
- Aspirieren aus einem Well, in das gemäss Deck-Zustand keine Flüssigkeit geladen ist.
- Dispensieren eines Volumens, das das Arbeitsvolumen des Ziel-Wells übersteigt.
- Aufnehmen einer Spitze aus einer Spitzenbox, die laut Simulator leer ist.
- Senden einer Bewegungsabfolge, die ein Hindernis auf dem Deck kreuzt.
LiquidBridge schaltet zwischen den MCP-Transport und den Adapter einen semantischen Validator. Er arbeitet mit dem Deck-Zustand des digitalen Zwillings, nicht mit dem physischen Gerät, und ist daher schnell und kostenlos. Im Produktivbetrieb weisen wir auf dieser Schicht rund 12 % der von Agenten generierten Tool-Aufrufe zurück - und keine dieser Zurückweisungen kostet Hardwarezeit.
# liquidbridge/validators/pipette_validator.py
from liquidbridge.types import PipetteOperation
from liquidbridge.state import DeckState
from liquidbridge.errors import ValidationError

class PipetteValidator:
    def __init__(self, deck: DeckState):
        self._deck = deck

    def check(self, op: PipetteOperation) -> None:
        well = self._deck.well(op.well)

        if op.mode == "aspirate":
            if well.liquid_volume_ul < op.volume.as_microliters():
                raise ValidationError(
                    code="INSUFFICIENT_VOLUME",
                    detail=(
                        f"well {op.well} has {well.liquid_volume_ul} uL, "
                        f"command requested {op.volume.as_microliters()} uL"
                    ),
                    fix_hint="aspirate from a well with sufficient volume, "
                             "or run a transfer step first",
                )

        if op.mode == "dispense":
            headroom = well.max_volume_ul - well.liquid_volume_ul
            if op.volume.as_microliters() > headroom:
                raise ValidationError(
                    code="WELL_OVERFLOW",
                    detail=(
                        f"well {op.well} has {headroom} uL headroom, "
                        f"command would dispense {op.volume.as_microliters()} uL"
                    ),
                    fix_hint="reduce volume or split across wells",
                )

        if not self._deck.tip_attached(op.channel):
            raise ValidationError(
                code="NO_TIP",
                detail=f"channel {op.channel} has no tip attached",
                fix_hint="call tip_pickup before aspirate or dispense",
            )
Zwei Designentscheidungen, die klein wirken, aber wichtig sind:
Fehler enthalten einen fix_hint. Erhält der Agent einen Validierungsfehler, bekommt er einen strukturierten, maschinenlesbaren Vorschlag für den nächsten Schritt. Das ist für autonome Schleifen entscheidend - ohne diesen Hinweis wiederholt der Agent denselben Aufruf. Mit dem Hinweis liest der Agent ihn und setzt zuerst ein tip_pickup ab. Die MCP-Roadmap 2026 bewegt sich mit strukturierter Fehlersemantik in dieselbe Richtung.
Die Validierung läuft gegen DeckState, nicht gegen das SDK. Dadurch funktioniert der Validator in der CI ohne angeschlossenes Gerät. Wir haben ~600 Unit-Tests, die den Validator gegen synthetische Deck-Zustände prüfen. Sie laufen alle in weniger als 4 Sekunden durch.
Ein Validator, der nur auf der Hardware läuft, ist ein Validator, den niemand ausführt.
Muster 3 - Fire-and-Poll für lang laufende Operationen (mit optionalem Abonnement)
Die dritte Erkenntnis: Ein Tool «Protokoll ausführen», das nach 45 Minuten einen einzigen String zurückgibt, ist unbrauchbar. Die naheliegende Lösung - «den Agenten einen Streaming-Ereigniskanal abonnieren lassen» - ist 2026 jedoch nicht so gelöst, wie es die MCP-Spezifikation erscheinen lässt.
MCP-Tools arbeiten standardmässig nach dem Request/Response-Prinzip. Die meisten Laboroperationen tun das nicht. Ein Transfer über 96 Wells kann 8 Minuten dauern. Ein vollständiges PCR-Setup mit Reagenzienvorbereitung, Mischen und Versiegeln der Platte kann eine Stunde dauern. Agenten müssen den Fortschritt sehen, auf Zwischenzustände reagieren und abbrechen können, wenn etwas nicht stimmt.
Der ehrliche Stand von MCP für lang laufende Operationen Anfang 2026
- Die MCP-Spezifikation
2025-06-18bietetnotifications/progress(Best Effort, keine garantierte Zustellung) und Ressourcenabonnements (resources/subscribe). Beides funktioniert über den Streamable-HTTP-Transport. - Die meisten heutigen Agenten-Clients - Claude Code, Claude Desktop, OpenAI Agents SDK, CrewAI, AG2, PydanticAI - leiten Fortschrittsbenachrichtigungen oder Ressourcenaktualisierungen während eines laufenden Tool-Aufrufs nicht an das Modell weiter. Sie zeigen sie in einer Benutzeroberfläche an, verwerfen sie auf Transportebene oder binden sie in Callbacks ein, die nie in den Reasoning-Kontext des Agenten zurückgelangen. Tracker-Issues: Claude Code #4157, OpenAI Agents SDK #661, PydanticAI #4266.
- LangGraph +
langchain-mcp-adaptersist derzeit der einzige verbreitete Stack, der Callbacks füronProgressundonResourcesUpdatedbereitstellt - wobei für die Zustellung über Streamable HTTP ein bekannter offener Bug besteht. - MCP
2025-11-25führte Tasks (SEP-1686) als experimentelles, offiziell vorgesehenes Muster für lang laufende Operationen ein:tools/callgibt sofort eintask-Objekt zurück; der Client interagiert übertasks/get,tasks/resultundtasks/cancel. FastMCP 2.14+ liefert eine vollständige serverseitige Implementierung. Die Lücke liegt bei der Übernahme durch die Clients.
Die MCP-Roadmap 2026 priorisiert die Härtung des Tasks-Lebenszyklus. Native Streaming-Ausgabe von Tools wird als «in Sicht» beschrieben, bislang ohne federführende Maintainer. Planen Sie entsprechend.
Pragmatisches Muster - Polling für die Wahrheit, Zuhören für die Geschwindigkeit
Beide Varianten nebeneinander zu implementieren, ist die Wette, die sich langfristig auszahlt. Die Polling-Schicht ist der universelle Fallback, den jeder MCP-Client nutzen kann; die Abonnement-Schicht ist ein willkommener Zusatznutzen für Clients, die mit der Zeit dafür gerüstet sind.
# liquidbridge/server/tools/run_protocol.py
from fastmcp import FastMCP
from liquidbridge.runtime import ProtocolRuntime, EventLog

server = FastMCP("liquidbridge")
runtime = ProtocolRuntime()
events = EventLog()

@server.tool(task=True)  # FastMCP 2.14+ implements MCP Tasks (SEP-1686).
                         # task-aware clients get tasks/get + tasks/cancel; older
                         # clients get a clean error if the call would exceed budget.
async def run_protocol(protocol: dict, dry_run: bool = False) -> dict:
    """Start a liquid-handling protocol. Long-running."""
    run_id = await runtime.start(protocol, dry_run=dry_run)
    final = await runtime.wait(run_id)
    return {"run_id": run_id, "status": final.status, "transfers": final.transfers}

@server.tool
async def run_events(run_id: str, since_seq: int = 0, max: int = 100) -> dict:
    """Drain typed events for a run. Universal polling fallback for clients
    that do not yet support MCP Tasks or resource subscriptions."""
    return {"events": [e.to_dict() for e in events.read(run_id, since_seq, max)]}

@server.resource("liquidbridge://runs/{run_id}")
async def run_resource(run_id: str):
    """Subscribable resource. Update notifications fire on every state
    transition. Useful for LangGraph + langchain-mcp-adapters today; will
    be useful for more clients as they grow resource-subscription support."""
    state = await runtime.snapshot(run_id)
    return {"text": state.to_json(), "mimeType": "application/json"}

@server.tool
async def cancel_run(run_id: str) -> dict:
    """Cancel a running protocol. Safe to call multiple times."""
    await runtime.cancel(run_id)
    return {"status": "cancellation_requested"}
Ereignisse sind typisiert. Die Laufzeitumgebung gibt einen definierten Satz aus: step_started, step_completed, liquid_transferred, tip_picked_up, tip_dropped, warning, error, protocol_completed. Der Agent weiss stets, welche Struktur er zu erwarten hat:
type LiquidBridgeEvent =
  | { type: "step_started"; step_index: number; description: string; eta_seconds: number }
  | { type: "step_completed"; step_index: number; duration_seconds: number }
  | { type: "liquid_transferred"; from: string; to: string; volume_ul: number }
  | { type: "warning"; code: string; detail: string; recoverable: boolean }
  | { type: "error"; code: string; detail: string; fix_hint?: string }
  | { type: "protocol_completed"; total_duration_seconds: number; transfers: number };
Die strukturellen Kosten: Jeder lang laufende Aufruf erzeugt nun eine run_id, die der Agent durch nachfolgende Aufrufe weiterreichen muss. Das ist eine Art Prompt-Engineering-Steuer - der Agent muss daran denken zu pollen -, aber es ist dieselbe Steuer, die auch das AWS SDK, die Stripe API und das Temporal SDK erheben. Ein gelöstes Problem.
Ein subtiler Punkt, den wir beim ersten Versuch falsch gemacht haben: Anfangs haben wir Ereignisse ausschliesslich als MCP-notifications gestreamt. Das funktionierte über eine stabile Verbindung, war aber nicht dauerhaft - trennte der Agent die Verbindung und stellte sie wieder her, ging der Ereignisverlauf verloren, und die meisten Clients leiteten die Benachrichtigungen ohnehin nicht an das Modell weiter. Die Lösung war das ausschliesslich anhängende EventLog, auf dem run_events() aufsetzt - der Agent rekonstruiert nach einer Wiederverbindung mit einem einzigen Polling-Aufruf den vollständigen Operationskontext, unabhängig davon, welchen Client er verwendet. Abonnements sind die richtige MCP-native Antwort; dauerhaftes Polling ist die Antwort, die heute tatsächlich auf jedem Client funktioniert.
Muster 4 - Plansimulation vor der physischen Ausführung
Die vierte Erkenntnis: Lassen Sie den ersten Kontakt eines Agenten mit dem physischen Gerät niemals eine echte Bewegung sein.
Jedes Protokoll, das LiquidBridge ausführt, durchläuft zuerst einen Simulator. Der Simulator ist ein digitaler Zwilling des Decks: jede Spitzenbox, jedes Well, jedes Flüssigkeitsvolumen, jede Kanalposition. Er führt denselben Protokoll-Codepfad aus wie der echte Adapter, und zwar gegen einen DeckState im Arbeitsspeicher, und erzeugt denselben Ereignisstrom.
Es handelt sich um denselben Ansatz, den Opentrons mit opentrons.simulate.get_protocol_api() und opentrons_simulate ausliefert und den PyLabRobot als SimulatorBackend bereitstellt. Das Muster ist gut etabliert. Die Lehre für einen MCP-Server lautet, die Simulation zum Standard zu machen und nicht zu einer Option, die man aktiv wählen muss.
In LiquidBridge durchläuft jeder run_protocol-Aufruf eine Ausführung in zwei Durchgängen:
# liquidbridge/runtime/protocol_runtime.py
class ProtocolRuntime:
    def __init__(self, real_adapter, sim_adapter, validator, events):
        self._real = real_adapter
        self._sim = sim_adapter
        self._validator = validator
        self._events = events

    async def start(self, protocol: dict, dry_run: bool = False) -> str:
        op_id = new_operation_id()

        # Pass 1: simulate, validating every step against the digital twin.
        # If anything fails here, the real instrument never moves.
        sim_result = await self._execute(protocol, self._sim, op_id, simulated=True)
        if not sim_result.ok:
            await self._events.emit(op_id, ErrorEvent(
                code="SIMULATION_FAILED",
                detail=sim_result.error,
                fix_hint=sim_result.fix_hint,
            ))
            raise SimulationFailed(sim_result.error)

        if dry_run:
            await self._events.emit(op_id, ProtocolCompletedEvent(
                total_duration_seconds=sim_result.duration,
                transfers=sim_result.transfers,
                simulated=True,
            ))
            return op_id

        # Pass 2: real execution against the vendor adapter.
        await self._execute(protocol, self._real, op_id, simulated=False)
        return op_id
Der Simulator macht sich auf drei Arten bezahlt:
Er erkennt strukturelle Fehler, die die Schema-Validierung nicht erkennen kann. Ein Protokoll, das 8 Spitzen aufnimmt, 6 davon verwendet und dann 4 weitere anfordert, ohne die vorhandenen abzuwerfen - das ist ein Programmierfehler, kein Schemafehler. Der Simulator erkennt ihn.
Er ermöglicht Agenten kostengünstige Iterationen. Die Simulation eines 45-minütigen Protokolls dauert ~120 ms. Ein Agent kann Hunderte von Varianten planen, validieren und verwerfen, bevor er sich auf eine festlegt. Das ist der Hauptgrund, weshalb ein Ansatz mit einem digitalen Zwilling des Labors bei autonomen Workflows tatsächlich Zeit spart.
Er bietet eine Sicherheitsgrenze, der Kunden vertrauen. Laborleitende genehmigen «dieses Protokoll darf ausgeführt werden», indem sie die Ausgabe des Simulators prüfen, nicht rohe MCP-Aufrufe. Der Ereignisstrom des Simulators ist für Menschen lesbar; das MCP-Übertragungsformat ist es nicht.
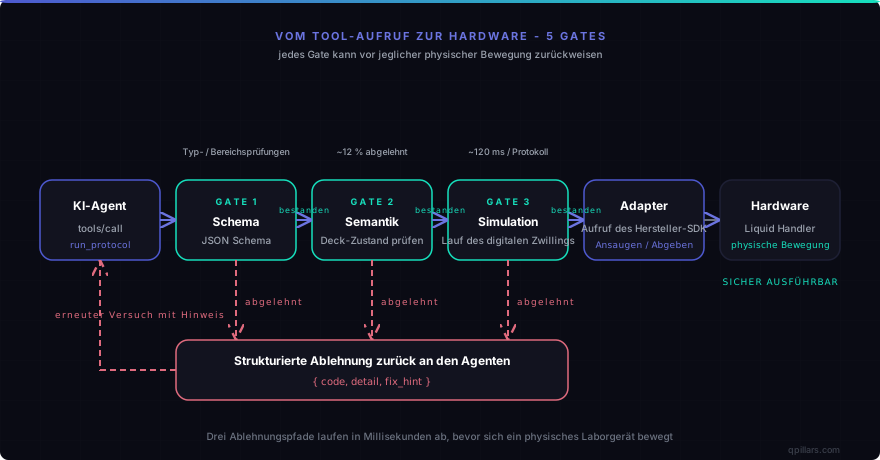
Das Ablaufdiagramm verfolgt einen einzelnen run_protocol-Aufruf vom Agenten bis zur Hardware. Jede Prüfstufe (Schema, Semantik, Simulation) kann den Aufruf vor jeder physischen Bewegung zurückweisen. Erst wenn alle drei bestanden sind, erhält der Herstelleradapter die Operation, und selbst dann verfolgt der Agent den Fortschritt über den Ereigniskanal, statt zu blockieren.
Was wir anders machen würden
Nach 18 Monaten stechen zwei Punkte hervor.
Den Simulator vom ersten Tag an als vollwertige MCP-Ressource behandeln. Anfangs haben wir Simulationsergebnisse nur als Teil der Rückgabewerte von run_protocol bereitgestellt. Kunden wollten jedoch den Deck-Zustand, die Spitzenboxen und die Flüssigkeitsvolumen prüfen - und zwar während des Laufs. Wir haben liquidbridge://state/deck und liquidbridge://state/tips/{box_id} später als MCP-Ressourcen nachgerüstet. Hätten wir das vom ersten Tag an umgesetzt, hätten wir uns ein Refactoring erspart und Verhaltensweisen von Agenten ermöglicht, die wir nicht vorhergesehen hatten.
dry_run zum Standard machen. Unsere erste Version führte echte Bewegungen aus, sofern nicht dry_run=true übergeben wurde. Als ein Agent das Flag zum ersten Mal vergass, kostete das eine echte Platte. Wir haben den Standard umgekehrt; nun muss dry_run=false explizit übergeben werden, und ein Konfigurationsflag auf Serverebene kann die reale Ausführung für ein bestimmtes Deployment vollständig deaktivieren. Wenn Sie einen MCP-Server für Laborgeräte entwickeln, wählen Sie standardmässig die sichere Variante.
Häufig gestellte Fragen
Was ist ein MCP-Server für Laborgeräte?
Ein MCP-Server für Laborgeräte ist ein Prozess, der die Fähigkeiten eines Geräts als Model-Context-Protocol-Tools bereitstellt, sodass KI-Agenten sie über einen einzigen offenen Standard erkennen, validieren und aufrufen können. Typischerweise kapselt er ein Hersteller-SDK, eine REST-API oder ein serielles Protokoll und übersetzt zwischen den MCP-Aufrufen des Agenten und der nativen Schnittstelle des Geräts. Eine vollständige Code-Erläuterung finden Sie in unserem Leitfaden zur MCP-Architektur.
Weshalb ein Hersteller-SDK in MCP kapseln, statt das SDK direkt aufzurufen?
Direkte SDK-Aufrufe binden Ihren KI-Agenten an einen Hersteller, eine Programmiersprache und ein Fehlermodell. Ein MCP-Server vereinheitlicht diese in einem einzigen Protokoll, ermöglicht dem Agenten, Fähigkeiten zur Laufzeit zu erkennen, und ergänzt eine Validierungsschicht, die verhindert, dass unsichere Aufrufe die Hardware erreichen. Zudem ist er wiederverwendbar - derselbe MCP-Server funktioniert ohne Änderungen mit jedem Agenten (Claude, GPT, Eigenentwicklung).
Wie gehen Sie in einem MCP-Server mit lang laufenden Protokollen um?
Verwenden Sie das MCP-Tasks-Muster aus der Spezifikation 2025-11-25 (SEP-1686) - das Tool gibt sofort ein task-Objekt zurück, und der Agent pollt über tasks/get und tasks/result. Stellen Sie ein synchrones Tool run_events(run_id, since_seq) als universellen Fallback für Clients bereit, die Tasks noch nicht unterstützen. Spiegeln Sie jedes laufende Protokoll als abonnierbare Ressource unter <server>://runs/{run_id} für den einzigen verbreiteten Stack (LangGraph + langchain-mcp-adapters), der Ressourcenaktualisierungen heute an das Modell weiterleitet. Ergänzen Sie ein Tool cancel_run, das bis zum Abbruchpfad des Hersteller-SDK durchgreift. Polling für die Wahrheit, Zuhören für die Geschwindigkeit.
Wie verhindern Sie, dass ein KI-Agent das Gerät beschädigt?
Führen Sie vor jeder physischen Bewegung drei Validierungsschichten aus: JSON-Schema-Validierung der Tool-Eingaben (durch MCP abgedeckt), semantische Validierung gegen den Deck-Zustand eines digitalen Zwillings (weist in unseren Produktionsdaten ~12 % der Aufrufe zurück) und vollständige Plansimulation gegen einen Adapter im Arbeitsspeicher. Setzen Sie dry_run=true auf Deployment-Ebene als Standard, damit ein vergessenes Flag nie eine physische Bewegung auslöst.
Sollte der Simulator ein separater Dienst sein oder im MCP-Server laufen?
Im selben Prozess, mit gemeinsamem Deck-Zustand mit dem Validator. Wird er als separater Dienst betrieben, müssen Sie den Zustand über das Netzwerk synchronisieren, was eine ganze Klasse von Konsistenzfehlern mit sich bringt. Wenn er im selben Prozess läuft, sehen Validator, Simulator und echter Adapter alle denselben DeckState - der einzig vernünftige Weg zu einer zuverlässigen Planvalidierung.
Zentrale Erkenntnisse
- Ein produktiver MCP-Server für Laborgeräte benötigt vier Schichten: einen Herstelleradapter, eine semantische Validierung, einen asynchronen Ereigniskanal und eine vollständige Plansimulation.
- Importe des Hersteller-SDK müssen sich in genau einer Datei befinden. Übersetzen Sie an der Grenze jede Hersteller-Exception in Ihre eigene Fehlertaxonomie.
- Die Validierung vor dem Tool-Aufruf gegen den Deck-Zustand des digitalen Zwillings erkennt die Fehler, die JSON Schema nicht erkennen kann - wir weisen auf dieser Schicht ~12 % der Agentenaufrufe zurück, bevor die Hardware sie überhaupt zu sehen bekommt.
- Lang laufende Operationen sollten MCP Tasks (SEP-1686) nutzen, wo der Client dies unterstützt, mit einem pollenden Tool
run_events(since_seq)als universellem Fallback und einer optionalen abonnierbaren Ressource für den LangGraph-Stack. Abonnements sind die richtige MCP-native Antwort; dauerhaftes Polling ist das, was heute auf jedem Client funktioniert. - Setzen Sie standardmässig
dry_run=true. Der erste Agent, der das Flag vergisst, kostet Sie eine echte Platte.
Verfasst von Iacob Marian, Technischer Leiter und Mitgründer von QPillars. Veröffentlicht am 30. April 2026. QPillars entwickelt in Zürich, Schweiz, LiquidBridge, den digitalen Zwilling und die MCP-Schicht für Liquid-Handling-Roboter.
Technischer Leiter und Mitgründer bei QPillars
Spezialisiert auf Laborautomatisierung – von der praktischen Gerätesteuerung und Flüssigkeitshandhabung bis zur KI-gestützten Orchestrierung von Protokollen.