
So entwickeln Sie zuverlässige KI-Agenten für Laborgeräte
So entwickeln Sie zuverlässige KI-Agenten für Laborgeräte
Ein LLM, das ein Gespräch führen kann, ist noch kein Agent, der ein Gerät steuern kann. Das sind zwei verschiedene Probleme. Das erste beeindruckt in einer Demo. Das zweite braucht ein Labor tatsächlich: einen Agenten, der jedes Mal genau das tut, worum er gebeten wurde, ohne Überraschungen beim 400. Durchlauf.
In diese Lücke fallen die meisten Projekte für KI in der Laborautomatisierung. Die Demo funktioniert. Dann formuliert jemand die Anfrage anders oder die Aufgabe wird um einen Schritt länger, und der Agent improvisiert. In einem Chatfenster ist Improvisation charmant. Auf einem Liquid-Handling-System mit einer echten Probe ist sie ein ruiniertes Experiment.
Wir entwickeln beruflich KI-Agenten für Laborgeräte, und die folgende Chronologie gibt wieder, was wir tatsächlich gelernt haben, ungefähr in der Reihenfolge, in der wir es gelernt haben. Nichts davon ist theoretisch. So gelangen Sie von «Schau, er hat mit dem Gerät gesprochen» zu einer Laborautomatisierung, der Sie vertrauen können.
Zuverlässigkeit ist das Produkt, nicht die Demo
Seien Sie zunächst ehrlich, was den Massstab betrifft. Ein Labor braucht keinen Agenten, der meistens richtig liegt. Es braucht einen Agenten, der auf eine Weise richtig liegt, die Sie messen und belegen können.
Das bedeutet zwei Dinge, die chat-zentriertes Denken meist ignoriert:
- Determinismus vor Raffinesse. Wenn sich ein Schritt berechnen lässt, berechnen Sie ihn. Lassen Sie das Modell keine Arithmetik, Geometrie oder Ablaufplanung erledigen, die ein paar Zeilen Code jedes Mal perfekt ausführen.
- Begrenztes Verhalten. Der Agent sollte über eine kleine, gut verstandene Menge an Handlungsmöglichkeiten verfügen. Je kleiner und klarer diese Oberfläche, desto zuverlässiger das System und desto einfacher seine Validierung.
Alles Folgende dient diesem Massstab.
Das Fundament: ein richtig umgesetzter MCP-Server
Das Fundament eines zuverlässigen Agenten für Laborgeräte ist der MCP-Server (Model Context Protocol). MCP ist der offene Standard, um einem KI-Agenten Tools bereitzustellen. Das Protokoll ist der einfache Teil. Der schwierige Teil, der darüber entscheidet, ob Ihr Agent zuverlässig ist, ist, was Sie bereitstellen und auf welcher Abstraktionsebene.
Die mit Abstand wichtigste Designentscheidung lautet: Stellen Sie einige wenige übergeordnete Intent-Tools auf einer einzigen Abstraktionsebene bereit und berechnen Sie alles Berechenbare in deterministischem serverseitigem Code.
Mit «Intent-Ebene» meinen wir Tools, die der Denkweise von Wissenschaftlerinnen und Wissenschaftlern entsprechen:
transfer_liquidplace_consumablesread_plate
Nicht die Ebene darunter:
move_to_positionlower_tipsset_pump_speedraise_z_axis
Die Intent-Tools sind das, was das Modell sehen sollte. Die Primitive sind das, was Ihr Servercode deterministisch orchestriert, sobald das Modell seinen Intent ausgedrückt hat. Das Modell entscheidet, was zu tun ist. Ihr Code entscheidet, wie, und zwar jedes Mal auf dieselbe Weise.
Das ist die Umkehrung des naheliegenden Ansatzes. Der naheliegende Ansatz besteht darin, alles bereitzustellen, was das Gerät kann, und das intelligente Modell den Rest herausfinden zu lassen. Genau das dürfen Sie nicht tun.
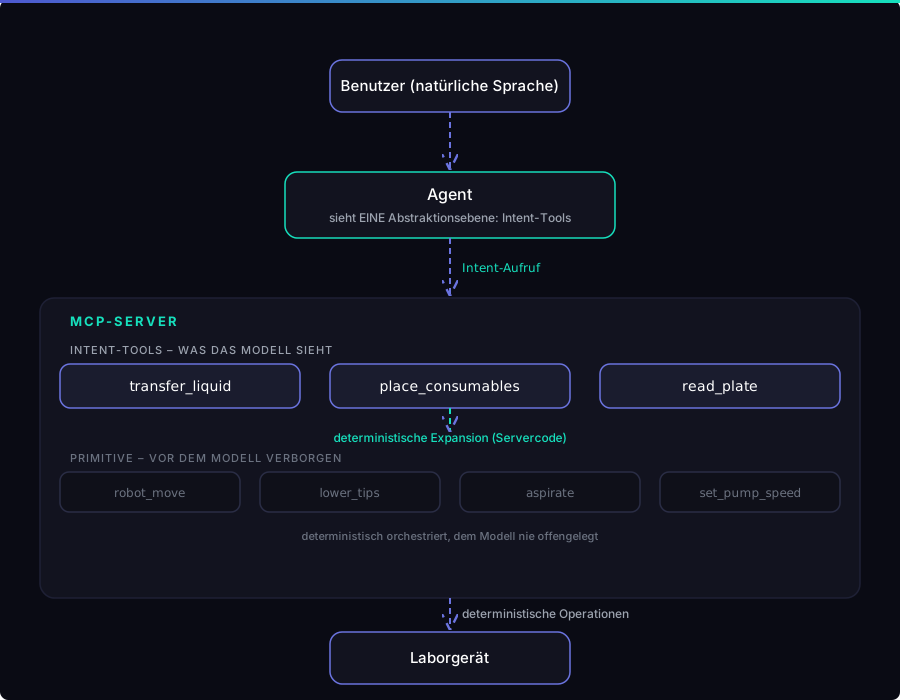
Der Agent sieht nur die Intent-Tools. Die Primitive unterhalb der Linie sind real, doch der Server orchestriert sie deterministisch, sobald das Modell seinen Intent ausgedrückt hat; das Modell berührt sie nie. Es ist dasselbe Muster, das wir in So verbinden Sie KI-Agenten über MCP mit Laborgeräten beschreiben, hier einen Schritt weiter in Richtung Zuverlässigkeit getrieben.
Warum gemischte Abstraktionsebenen Agenten scheitern lassen – ein gemessener Befund
Hier ist der konkrete Befund, der dies für uns zu einer nicht verhandelbaren Vorgabe gemacht hat.
Richten Sie einen leistungsfähigen, generischen Agenten auf eine Tool-Oberfläche, die übergeordnete Intents und Low-Level-Primitive mischt, und er gerät aus der Spur. Er beginnt, die Primitive von Hand zusammenzusetzen – hierhin bewegen, dort absenken, dies prüfen, das anpassen – und arbeitet sich Schritt für Schritt durch Arbeit, die der Server in einem Zug hätte erledigen sollen.
In unseren eigenen gemessenen Tests führte eine solche Anfrage zu rund 13 Tool-Aufrufen und verbrauchte etwa 70'000 Tokens für eine Aufgabe, die ein einziger Intent-Aufruf hätte sein sollen. Das Modell war nicht defekt. Es tat genau das, wozu eine Oberfläche mit gemischten Abstraktionsebenen einlädt: Es improvisierte ein Verfahren aus Primitiven. Mehr Aufrufe bedeuten mehr Stellen, an denen es abdriften kann, mehr Latenz, mehr Kosten und mehr Möglichkeiten, dass eine physische Aktion falsch ausgeführt wird.
Die Kuratierung der Tool-Oberfläche auf eine einzige Intent-Ebene war die wirkungsvollste Designentscheidung, die wir getroffen haben. Nicht das Modell. Nicht das Framework. Die Tool-Oberfläche.
Zuverlässigkeit liegt in der Architektur, nicht im Framework
Sobald Sie ein MCP auf Intent-Ebene haben, ist das zuverlässige Muster kurz und grösstenteils keine «KI»:
- MCP auf Intent-Ebene – das Modell drückt in einigen wenigen kuratierten Tools aus, was die Wissenschaftlerin oder der Wissenschaftler möchte.
- Deterministische Expansion – serverseitiger Code übersetzt diesen Intent in die exakte, validierte Abfolge von Geräteoperationen.
- Planen-Validieren-Reparieren-Schleife – den Plan erstellen, ihn gegen reale Randbedingungen validieren (Volumina, Positionen, Zustand der Spitzen, Deck-Layout) und ihn reparieren oder verwerfen, bevor irgendetwas Physisches geschieht.
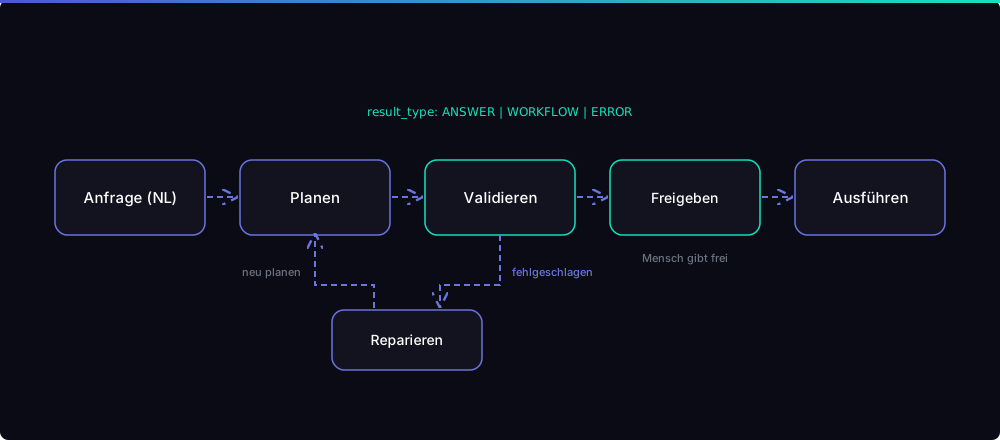
Der Plan ist eine geordnete Liste von Intent-Schritten: Der MCP-Vertrag legt fest, welche Schritte möglich sind, der Agent bestimmt, welche davon für diese Anfrage verwendet werden, und ein Mensch erteilt die Freigabe, bevor irgendetwas ausgeführt wird. Ein Plan, der die Validierung nicht besteht, wird repariert und neu geplant, aber nie ausgeführt.
Wir haben dieselbe Zuverlässigkeit über mehrere Agenten-Frameworks hinweg gemessen, die auf diesem Design aufsetzen. Dieses Ergebnis verdient es, dass man darüber nachdenkt: Wenn die Architektur stimmt, ist das Framework ein Detail. Es werden wochenlange Diskussionen darüber geführt, welches Agenten-Framework man einsetzen soll. In unseren Tests war es nicht das Framework, das die Zuverlässigkeitskennzahl bewegt hat. Es war das MCP auf Intent-Ebene zusammen mit der deterministischen Expansion und der Validierungsschleife.
Wenn Sie also entscheiden, wo Sie Ihren Entwicklungsaufwand investieren: Investieren Sie ihn in die Tool-Oberfläche und die deterministische Schicht, nicht in einen Framework-Vergleich.
Evaluieren, bevor etwas eine Laboroberfläche erreicht
Das Recht, einen Agenten vor eine Wissenschaftlerin oder einen Wissenschaftler zu stellen, erwerben Sie nicht dadurch, dass eine Demo funktioniert. Sie erwerben es durch Messen.
Definieren Sie vor jeder Benutzeroberfläche Ihre Anwendungsfälle und sammeln Sie für jeden Anwendungsfall viele reale Formulierungen von Benutzerinnen und Benutzern. Wissenschaftlerinnen und Wissenschaftler sprechen nicht in kanonischen Befehlen. «Move 50 microliters from A1 to B1», «transfer 50 ul, well A1 into B1» und «pipette fifty microlitres across to B1» sind derselbe Intent in drei Sätzen. Ihr Benchmark muss diese Bandbreite abdecken.
Messen Sie dann bei jedem Anwendungsfall drei Dinge:
- Genauigkeit – Wählt und verwendet der Agent für diesen Intent die richtigen Tools mit den richtigen Argumenten?
- Zuverlässigkeit – Führen Sie ihn N-mal aus. Er muss jedes Mal bestehen. Ein Test, der 9 von 10 Malen besteht, ist durchgefallen.
- Kosten und Latenz – Tokens und Sekunden pro Aufgabe. Hier verlieren Designs mit gemischten Abstraktionsebenen unbemerkt an Substanz, während Designs auf Intent-Ebene günstig und schnell bleiben.
All dies geschieht, bevor irgendetwas eine Laboroberfläche erreicht. Die Evaluierungsumgebung ist keine Phase, die Sie am Ende durchlaufen. Sie ist das, was Ihnen sagt, ob Sie ein Produkt oder eine Demo haben.
Mit Skills wachsen und die Anzahl als Signal nutzen
Beginnen Sie mit einem Agenten ohne Skills: nur das MCP auf Intent-Ebene, sonst nichts. Lassen Sie ihn gegen Ihren Benchmark laufen. Das zeigt Ihnen die reine Qualität des MCP selbst, ohne Unterstützung. Wenn der Agent ohne jedes Hilfsgerüst bei einfachen Intents Schwierigkeiten hat, liegt das Problem in der Tool-Oberfläche, und kein noch so umfangreiches Hilfsgerüst darüber wird das sauber beheben.
Wenn die Aufgaben komplexer werden, fügen Sie Skills hinzu – geroutete Rezepte, die den Agenten durch eine bestimmte mehrstufige Aufgabe führen und dabei dieselben Intent-Tools darunter verwenden. Mit Skills steigern Sie die Zuverlässigkeit bei anspruchsvolleren Workflows, ohne die Tool-Oberfläche zu erweitern oder den Determinismus zu lockern.
Hier steckt ein unscheinbares Diagnoseinstrument: Die Anzahl der Skills, die ein MCP benötigt, um eine bestimmte Zuverlässigkeit zu erreichen, ist selbst ein Qualitätssignal. Ein sauberes, gut gestaltetes Intent-MCP benötigt wenige Skills, um zuverlässig zu sein. Wenn Sie feststellen, dass Sie für jede zweite Aufgabe einen Skill schreiben, nur um den Agenten in der Spur zu halten, sagt Ihnen das MCP damit, dass seine Abstraktionsebene oder seine Abgrenzungen falsch sind. Hören Sie darauf.
Der Ertrag: Automatisierung, der Sie vertrauen können
Fügt man alles zusammen, ist das Rezept nicht geheimnisvoll:
- Einige wenige Intent-Tools auf einer einzigen Abstraktionsebene, wobei alles Berechenbare deterministisch berechnet wird.
- Eine Planen-Validieren-Reparieren-Schleife, damit auf Grundlage eines nicht validierten Plans nichts Physisches geschieht.
- Eine Evaluierungsumgebung, die Genauigkeit, Zuverlässigkeit und Kosten anhand realer Formulierungen misst, bevor eine Benutzeroberfläche existiert.
- Bewusst hinzugefügte Skills, wobei die Anzahl der Skills als Signal über das darunterliegende MCP gelesen wird.
Ein hochwertiges MCP zusammen mit einem gemessenen Agenten ist der Weg zu KI für die Laborautomatisierung, der Sie in einem realen Labor vertrauen können – nicht zu einem Clip, der einmal gut aussieht. Die Zuverlässigkeit liegt im Design, und das Design ist die eigentliche Arbeit.
Die wichtigsten Erkenntnisse
- Der Massstab für KI-Agenten, die Laborgeräte steuern, ist Zuverlässigkeit, nicht sprachliche Gewandtheit im Gespräch.
- Das Fundament ist ein MCP-Server, der einige wenige übergeordnete Intent-Tools auf einer einzigen Abstraktionsebene bereitstellt und alles Übrige in deterministischem serverseitigem Code berechnet.
- Die Vermischung von Intent-Tools mit Low-Level-Primitiven bringt Agenten aus der Spur – in unseren Tests rund 13 Tool-Aufrufe für eine Aufgabe, die einer hätte sein sollen.
- Zuverlässigkeit liegt in der Architektur (Intent-MCP + deterministische Expansion + Planen-Validieren-Reparieren), nicht in der Wahl des Agenten-Frameworks.
- Evaluieren Sie vor jeder Benutzeroberfläche: Definieren Sie Anwendungsfälle, sammeln Sie reale Formulierungen und messen Sie Genauigkeit, Zuverlässigkeit (jedes Mal bestehen, nicht meistens) und Kosten.
- Beginnen Sie mit einem Agenten ohne Skills, um das MCP selbst zu testen, und fügen Sie dann Skills hinzu – die Anzahl der für Zuverlässigkeit benötigten Skills ist ein Qualitätssignal über das MCP.
Häufig gestellte Fragen
Was macht einen KI-Agenten für ein Laborgerät zuverlässig?
Zuverlässigkeit entsteht durch die Architektur, nicht durch das Modell: ein MCP-Server auf Intent-Ebene, die deterministische Expansion dieser Intents in validierte Geräteoperationen und eine Planen-Validieren-Reparieren-Schleife, die fehlerhafte Pläne verwirft, bevor irgendetwas Physisches geschieht. Der Agent entscheidet, was zu tun ist; deterministischer Code entscheidet, wie, und zwar jedes Mal auf dieselbe Weise.
Warum ist MCP das richtige Fundament für KI in der Laborautomatisierung?
Das Model Context Protocol ist ein offener Standard, um KI-Agenten Tools bereitzustellen. Bei Laborgeräten ermöglicht es Ihnen, eine kleine, kuratierte Auswahl an Intent-Tools bereitzustellen, die der Denkweise von Wissenschaftlerinnen und Wissenschaftlern entsprechen, während die mechanischen Primitive verborgen bleiben. Diese kuratierte Tool-Oberfläche ist der wichtigste Einzelfaktor dafür, ob der Agent zuverlässig ist.
Sollte ich dem KI-Agenten jede Gerätefunktion bereitstellen?
Nein. Werden Low-Level-Primitive neben übergeordneten Intents bereitgestellt, verleitet das den Agenten dazu, Verfahren Schritt für Schritt zu improvisieren, was langsamer, teurer und fehleranfälliger ist. Stellen Sie ausschliesslich Intent-Tools bereit und orchestrieren Sie die Primitive deterministisch im Servercode.
Wie testet man einen KI-Agenten für ein Laborgerät vor dem Einsatz?
Definieren Sie Anwendungsfälle und sammeln Sie für jeden viele reale Formulierungen von Benutzerinnen und Benutzern. Messen Sie dann Genauigkeit (richtige Tools und Argumente), Zuverlässigkeit (er muss jeden wiederholten Durchlauf bestehen, nicht nur die meisten) sowie Kosten und Latenz. All dies geschieht, bevor der Agent eine Laboroberfläche erreicht, und zwar gegen das MCP statt gegen das physische Gerät.
Was sind Skills und wie viele sollte ein Agent haben?
Skills sind geroutete Rezepte, die einen Agenten durch eine bestimmte mehrstufige Aufgabe führen und dabei dieselben Intent-Tools verwenden. Beginnen Sie mit null Skills und fügen Sie welche erst hinzu, wenn die Aufgaben komplexer werden. Wenn Sie für nahezu jede Aufgabe einen Skill benötigen, ist das ein Signal dafür, dass die Tool-Oberfläche des MCP falsch ist.
Für die Grundlagen lesen Sie So verbinden Sie KI-Agenten über MCP mit Laborgeräten und Das MCP-Protokoll für die Laborautomatisierung. Wohin die Entwicklung führt, erfahren Sie unter Agentische KI für Labor-Workflows.
Iacob ist technischer Leiter bei QPillars, einem Unternehmen mit Sitz in Zürich, das intelligente Software-Infrastruktur für Laborgeräte in den Life Sciences entwickelt. Wir liefern Gerätesoftware, die standardmässig für Agenten bereit ist: MCP-Server auf Intent-Ebene, evaluierte Agenten und digitale Zwillinge für sicheres iteratives Arbeiten. Kontaktieren Sie uns unter iacob@qpillars.com.
Technischer Leiter und Mitgründer bei QPillars
Spezialisiert auf Laborautomatisierung – von der praktischen Gerätesteuerung und Flüssigkeitshandhabung bis zur KI-gestützten Orchestrierung von Protokollen.