
KI-Agenten für die Laborautomatisierung entwerfen: Bei der Frage beginnen, nicht bei der API
KI-Agenten für die Laborautomatisierung entwerfen: Bei der Frage beginnen, nicht bei der API
Wer einen KI-Agenten entwerfen will, der ein Laborgerät gut bedient, beginnt bei den Fragen, die eine Wissenschaftlerin oder ein Wissenschaftler ihm tatsächlich stellen würde, und nicht bei der API des Geräts. Die Fragen legen fest, welche Tools der Agent benötigt, mit welchen Skills er sie kombiniert und mit welchen Tests sich nachweisen lässt, dass er funktioniert. Danach folgt ein Benchmark, denn an einem echten Gerät ist der Unterschied zwischen einer gut entworfenen Tool-Oberfläche und einer naiven nicht kosmetisch: In unseren eigenen Messungen sind es rund 16-mal weniger Tokens, eine 11-mal schnellere Ausführung und der Unterschied zwischen einer Antwort und einem stillen Fehlschlag.
Das ist das Gegenteil davon, wie die meisten Integrationen von Laborgeräten gebaut werden. Standardmässig nimmt man die Schnittstelle des Geräts, also sein SDK oder seinen SiLA-2-Feature-Satz, und stellt jeden Befehl als Tool bereit. Das wirkt gründlich. Es entsteht jedoch ein Agent, der langsam, teuer und unzuverlässig ist. Im Folgenden beschreiben wir die Methode, bei der das nicht passiert.
Die wichtigsten Erkenntnisse
- Bei den Fragen beginnen, nicht bei der API. Halten Sie fest, worum Wissenschaftlerinnen und Wissenschaftler den Agenten bitten; jede Frage prägt den Entwurf.
- Tools auf Intent-Ebene entwerfen, eines pro Ergebnis und nicht eines pro API-Endpunkt. Die Schnittstelle eines Geräts eins zu eins zu kapseln, ist der häufigste und folgenschwerste Fehler.
- Weniger, ergebnisorientierte Tools setzen sich durch. Die Genauigkeit der Tool-Auswahl bricht bei grossen Tool-Sätzen ein; die Verschlechterung beginnt bei 15 bis 20 Tools, lange vor einer harten Grenze.
- Der Fragenkatalog ist ein einziges Artefakt mit drei Verwendungszwecken: Er definiert die Tools, die Skills des Agenten und die Evaluationsszenarien.
- Benchmarks am konkreten Anwendungsfall durchführen. Token-Kosten, Anzahl der Tool-Aufrufe und Latenz sind im Labor Produkteigenschaften; eine Wissenschaftlerin wartet nicht zehn Minuten, während ein Agent in Schleifen läuft.
- Unsere Daten: Auf demselben Gerät und mit demselben Modell führte eine komponierte Tool-Oberfläche auf Intent-Ebene einen Workflow mit 8'441 Tokens in 6,1 Sekunden aus; die rohe Oberfläche benötigte 134'294 Tokens, 45 Tool-Aufrufe und 69 Sekunden; eine schlecht zugeschnittene, schmale Oberfläche tat stillschweigend nichts.
Der Fehler: Die Schnittstelle des Geräts kapseln
Die Steuerungsschnittstelle eines Geräts ist für Ingenieurinnen und Ingenieure geschrieben. Sie stellt Primitive bereit – bewegen, aspirieren, dispensieren, Parameter setzen, Status lesen –, weil eine Programmiererin diese zu einem Ablauf zusammensetzt. Naheliegend ist es, dem Agenten all diese Primitive als Tools zu übergeben und darauf zu vertrauen, dass er den Rest selbst herausfindet.
Das funktioniert nicht, und die Gründe sind inzwischen gut dokumentiert. Steht ein Agent vor einem grossen Tool-Satz, sinkt die Genauigkeit der Tool-Auswahl stark; eine Analyse beziffert sie auf nahezu 13 % bei grossen Tool-Sätzen, wobei eine echte Verschlechterung eintritt, sobald ein Agent mehr als 15 bis 20 Tools im aktiven Einsatz hat. Die Branche hat dies auf die harte Tour gelernt: GitHub Copilot reduzierte seine Anzahl Tools von 40 auf 13 und verzeichnete bessere Benchmark-Ergebnisse; Block baute seine Linear-Integration von über 30 Tools auf 2 um. Wie es in einer Analyse von AWS heisst, ist ein MCP-Server «eine Schnittstelle für Intentionen» und kein Spiegelbild Ihrer API.
Im Labor ist dies gravierender als in einer SaaS-Anwendung, denn die Primitive sind die falsche Denkeinheit, und die Kosten eines Fehlers sind physischer Natur. Ein Agent, der zwanzigmal über move und aspirate nachdenkt, hat zwanzig Gelegenheiten, auf einer Maschine, die eine echte Probe verbraucht, falsch zu wählen. Die Einheit, über die der Agent nachdenken sollte, ist kein Primitiv. Es ist die Absicht der Wissenschaftlerin oder des Wissenschaftlers.
Fazit: Die API eines Geräts ist die falsche Tool-Oberfläche für einen Agenten, weil sie für eine Programmiererin entworfen wurde und nicht für ein schlussfolgerndes System.
Die Methode: Bei den Fragen beginnen
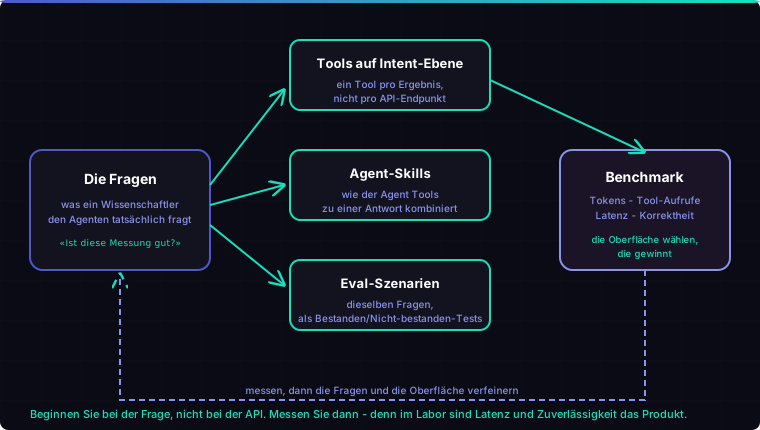
1. Die Fragen aufschreiben. Halten Sie vor jeder Zeile Code fest, worum eine Wissenschaftlerin oder ein Wissenschaftler den Agenten tatsächlich bitten würde, und zwar in deren eigenen Worten. «Ist diese Messung gut genug, um sie zu behalten?» «Was ist in dieser Probe?» «Richte eine Verdünnungsreihe über die Platte ein.» «Warum ist der letzte Lauf fehlgeschlagen?» Diese Liste ist die Spezifikation. Sie ist günstig zu erstellen und das wertvollste einzelne Artefakt des Projekts.
2. Jede Frage in ein Tool auf Intent-Ebene überführen. Eine Frage entspricht einem Ergebnis, und das Ergebnis ist das Tool. «Eine Verdünnungsreihe einrichten» ist ein einziges Tool – prepare_dilution_series – und nicht elf aspirate/dispense-Aufrufe, deren Orchestrierung der Agent übernehmen muss. Das Tool nimmt die Parameter entgegen, die eine Wissenschaftlerin angeben würde (Konzentrationen, Plattenlayout), und übernimmt die Choreografie der Primitive intern, hinter einer validierten Schnittstelle. Der Agent denkt über das Experiment nach; das Tool kümmert sich um die Mechanik.
3. Die Fragen definieren lassen, welche Skills es braucht. Manche Fragen erfordern mehr als ein Tool, die nacheinander kombiniert werden – erfassen, dann die Qualität beurteilen, dann interpretieren. Diese Kombinationen sind die Skills des Agenten, und sie ergeben sich direkt aus der Form der Fragen, nicht aus Vermutungen.
4. Die Fragen definieren lassen, wie evaluiert wird. Dieselbe Liste ist Ihre Testsuite. Jede Frage wird zu einem Szenario mit einem bekannten korrekten Ergebnis, das wiederholt ausgeführt und mit bestanden oder nicht bestanden bewertet wird. Sie schreiben nicht zuerst den Agenten und fragen sich dann, wie Sie ihn testen sollen – die Fragen waren von Anfang an die Tests.
5. Erst Benchmark, dann Auswahl. Bauen Sie die Kandidaten-Tool-Oberfläche und messen Sie sie an den realen Workflows: verbrauchte Tokens, ausgeführte Tool-Aufrufe, tatsächliche Latenz und Korrektheit über Wiederholungen hinweg. Wählen Sie dann die Oberfläche, die sich durchsetzt. Das ist kein optionaler Feinschliff – siehe unten.
Fazit: Die Fragen, die eine Wissenschaftlerin oder ein Wissenschaftler stellt, bilden eine einzige Spezifikation, die Tools, Skills und Tests zugleich prägt.
Warum Benchmarks unerlässlich sind: Latenz und Zuverlässigkeit sind Produkteigenschaften
Bei einem Chatbot fallen ein paar zusätzliche Sekunden und einige tausend Tokens nicht auf. An der Laborbank sind sie das Produkt. Eine Wissenschaftlerin, die an einem Gerät steht, wartet nicht, während ein Agent vierzigmal eine Schleife durchläuft, um eine Antwort zusammenzusetzen, und ein Agent, der gelegentlich stillschweigend nichts tut, ist schlimmer als gar kein Agent.
Deshalb haben wir es gemessen. Mit LiquidBridge, unserem digitalen Zwilling eines Liquid-Handlers, haben wir dieselben Workflows mit demselben Modell gegen drei verschiedene Entwürfe von Tool-Oberflächen über demselben zugrunde liegenden Gerät ausgeführt. Geändert hat sich einzig die Form der bereitgestellten Tools.
| Tool-Oberfläche | Anspruchsvollster Workflow (Proben mit Reagenzien mischen) |
|---|---|
| Roh – jedes Primitiv bereitgestellt | 134'294 Tokens, 45 Tool-Aufrufe, 69 Sekunden |
| Schmal – eine dünne, zu eng zugeschnittene Oberfläche | fehlgeschlagen, 0 von 2 Läufen, null Tool-Aufrufe – kein Fehler, sondern gar nichts |
| Komponiert – Tools auf Intent-Ebene | 8'441 Tokens, 4 Tool-Aufrufe, 6,1 Sekunden |
Die komponierte Oberfläche führte dieselbe Aufgabe mit rund 16-mal weniger Tokens und 11-mal schneller aus, ohne Einbusse bei der Korrektheit – allein dadurch, dass die Darstellung des Geräts gegenüber dem Agenten geändert wurde. Am Gerät selbst änderte sich nichts.
Die mittlere Zeile verdient besondere Aufmerksamkeit. Die schmale Oberfläche hat keinen Fehler ausgelöst. Sie hat bei der anspruchsvollen Aufgabe stillschweigend nichts geliefert – der gefährlichste Fehlermodus in der Nähe von Hardware, weil ein Mensch eine ausbleibende Antwort als «läuft noch» und nicht als «defekt» deutet. Diese Art von Fehler erkennen Sie nur durch Benchmarks mit Bestanden/Nicht-bestanden-Szenarien, und genau diese liefert Ihnen Schritt 4.
Zwei ehrliche Einschränkungen: LiquidBridge ist ein digitaler Zwilling und kein physisches Gerät, und diese Zahlen stammen von einer einzigen Modellfamilie mit einer geringen Anzahl Wiederholungen. Betrachten Sie sie als Richtungsangabe, nicht als universellen Benchmark. Doch genau auf die Richtung kommt es an – auf der Ebene zwischen Gerät und Agent werden Zuverlässigkeit und Kosten gewonnen oder verloren, und in der Laborautomatisierung misst sie kaum jemand.
Fazit: Die Tool-Oberfläche ist eine Leistungsentscheidung, und ohne Messung an den realen Workflows lässt sie sich nicht gut treffen.
Warum dies im Labor schwieriger und wertvoller ist
Allgemeine Ratschläge, Tools «rund um die Intention zu konsolidieren», sind inzwischen allgegenwärtig. Sie auf Geräte anzuwenden, ist aus drei Gründen schwieriger, und jeder davon ist ein Grund, es gut zu machen.
Die Primitive sind tatsächlich sehr systemnah – ein Geräte-SDK liefert Bewegung und I/O, keine Experimente –, sodass die Intent-Ebene, die darauf aufgebaut werden muss, umfangreicher ist als bei einer typischen Web-API. Die richtigen Intent-Tools erfordern Fachwissen: Zu wissen, dass «ist diese Messung gut» bei einem Gerät das Signal-Rausch-Verhältnis bedeutet und bei einem anderen etwas anderes, macht den Unterschied zwischen einem nützlichen und einem falschen Tool aus. Und die Kosten eines fehlerhaften Tool-Aufrufs sind physisch und manchmal irreversibel, was die Anforderungen an die Zuverlässigkeit weit über die eines reinen Software-Agenten hebt.
Diese Schwierigkeit ist der Burggraben. Eine Tool-Oberfläche auf Intent-Ebene für ein Laborgerät bildet echtes Laborwissen ab und ist das Gegenteil eines Eins-zu-eins-API-Wrappers, den jeder generieren kann. Sie ist der Teil eines agentischen Laborsystems, der tatsächlich schwer zu bauen ist – und deshalb der Teil, den es sich lohnt, gut zu bauen.
Häufig gestellte Fragen
Wie entwirft man Tools für einen KI-Agenten, der ein Laborgerät steuert?
Beginnen Sie bei den Fragen, die eine Wissenschaftlerin oder ein Wissenschaftler dem Agenten stellen würde, und überführen Sie jede Frage in ein einzelnes Tool auf Intent-Ebene, das das Ergebnis liefert – nicht ein Tool pro API-Endpunkt des Geräts. Derselbe Fragenkatalog definiert auch die Skills des Agenten und seine Evaluationsszenarien. Unterziehen Sie anschliessend die Kandidaten-Tool-Oberflächen einem Benchmark hinsichtlich Token-Kosten, Anzahl der Tool-Aufrufe, Latenz und Korrektheit, und setzen Sie diejenige ein, die sich durchsetzt.
Warum nicht einfach die gesamte API des Geräts als Tools bereitstellen?
Weil die Genauigkeit der Tool-Auswahl bei grossen Tool-Sätzen stark nachlässt – spürbar ab 15 bis 20 Tools –, sodass ein Agent, dem Dutzende systemnahe Primitive übergeben werden, langsam, teuer und unzuverlässig wird. Geräteprimitive sind zudem die falsche Einheit für ein schlussfolgerndes Modell: Es sollte über das Experiment nachdenken, nicht über einzelne Bewegungs- und I/O-Aufrufe.
Was ist ein Tool auf Intent-Ebene?
Ein Tool, das durch das Ergebnis definiert ist, das eine Wissenschaftlerin oder ein Wissenschaftler anstrebt, und nicht durch ein Maschinenprimitiv. «Eine Verdünnungsreihe vorbereiten» oder «Messqualität beurteilen» sind Tools auf Intent-Ebene; aspirate, dispense und read_status sind Primitive. Das Tool auf Intent-Ebene nimmt die Parameter entgegen, die eine Wissenschaftlerin angeben würde, und übernimmt die Choreografie der Primitive intern, hinter einer validierten Schnittstelle.
Wie viel macht das Design der Tool-Oberfläche tatsächlich aus?
In unseren Messungen an einem digitalen Zwilling eines Liquid-Handlers führte eine komponierte Oberfläche auf Intent-Ebene einen Workflow mit rund 16-mal weniger Tokens und 11-mal schneller aus als eine rohe Oberfläche aus Primitiven, ohne Einbusse bei der Korrektheit – und eine schlecht zugeschnittene Oberfläche schlug stillschweigend fehl. Im Labor, wo Latenz und Zuverlässigkeit Produkteigenschaften sind, ist dieser Unterschied entscheidend.
Brauche ich weiterhin SiLA 2 oder MCP, wenn ich Tools auf diese Weise entwerfe?
Ja – sie ergänzen sich. Über SiLA 2 oder ein Hersteller-SDK erreichen Sie die Primitive des Geräts; über MCP stellen Sie Ihre Tools auf Intent-Ebene jedem beliebigen Agenten bereit. Bei der hier beschriebenen Methode geht es darum, welche Tools Sie auf dieser Infrastruktur entwerfen und wie Sie sie validieren.
Sie bauen einen Laboragenten? Wir entwerfen die Tool-Ebene zwischen Agenten und Geräten – Tools auf Intent-Ebene, die Skills, die sie kombinieren, und die Evaluationsumgebung, die belegt, dass sie funktionieren – und wir messen sie an realen Workflows. Wenn Sie ein Gerät und eine Reihe von Fragen haben, die Ihre Wissenschaftlerinnen und Wissenschaftler ihm stellen, nehmen Sie Kontakt mit uns auf, und wir sagen Ihnen, was ein Agent damit leisten kann und was er pro Antwort kosten wird.
Technischer Leiter und Mitgründer bei QPillars
Spezialisiert auf Laborautomatisierung – von der praktischen Gerätesteuerung und Flüssigkeitshandhabung bis zur KI-gestützten Orchestrierung von Protokollen.