
So bauen Sie eine Orchestrierungsplattform für die Laborautomatisierung
So bauen Sie eine Orchestrierungsplattform für die Laborautomatisierung
Um eine Orchestrierungsplattform für die Laborautomatisierung zu bauen, stellen Sie vier Schichten bereit: eine Benutzeroberfläche, eine Orchestrierungs-Engine, eine Geräteabstraktionsschicht und den Gerätepark. Schwierig ist nur die Engine. In ihrem Kern steht eine Ausführungsschleife: Sie wählt den nächsten ausführbereiten Schritt in einem Workflow, übergibt einen Befehl zur Ausführung an das richtige Gerät, verfolgt das zurückgestreamte Ergebnis, aktualisiert den Zustand und entscheidet, was als Nächstes ausgeführt wird. Das wiederholt sich, bis der Lauf abgeschlossen ist. Die entscheidende Weichenstellung ist die Geräteschnittstelle: Wählen Sie eine einheitliche, selbstbeschreibende Schnittstelle für jedes Gerät, sonst geht die Schleife in herstellerspezifischen Sonderfällen unter. Dieser Leitfaden führt Sie durch den Aufbau in der Reihenfolge, in der diese Entscheidungen tatsächlich verbindlich werden.
Als konkrete Schnittstelle verwenden wir durchgehend SiLA 2, weil es die sauberste herstellerneutrale Option für Laborgeräte ist. Wir enden bei der Steuerungsschicht. Ergebnisse in ein ELN oder LIMS zu bringen, ist ein anderes Problem, auf das wir am Ende einen Ausblick geben.
Schritt 0: Das Problem klar benennen
Ein reales Labor ist eine Ansammlung von Geräten, die sich auf nichts einigen: ein Liquid-Handling-System, das über ein C++-SDK des Herstellers angesteuert wird, ein Roboterarm hinter einem proprietären TCP-Socket, ein Plattenleser mit REST-API, ein Inkubator an einer seriellen RS-232-Schnittstelle, eine Zentrifuge, die sich nur über ihre eigene GUI bedienen lässt.
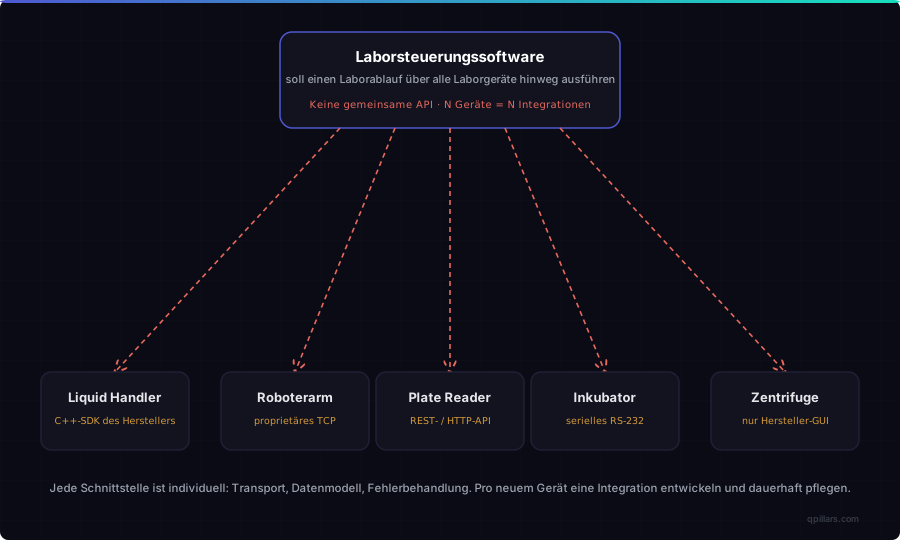
Diagramm 1: Das Problem, gegen das Sie anbauen. Fünf Geräte, fünf Schnittstellen, fünf massgeschneiderte Integrationen. Die Kosten liegen nicht in einer einzelnen Verbindung, sondern darin, dass der Aufwand O(N) ist und jedes neue Gerät weiteren Integrationscode hinzufügt, der über seine gesamte Lebensdauer gepflegt werden muss.
«Einfach ein Skript pro Gerät schreiben» funktioniert bei zwei Geräten und bricht in dem Moment zusammen, in dem sich ein Workflow mit Verzweigungen und Fehlerbehandlung über den gesamten Gerätepark erstreckt. Der ganze Sinn der Plattform besteht darin, dass die Integrationskosten nicht weiter wachsen.
Schritt 1: Die Schichten festlegen
Gliedern Sie die Plattform in vier Schichten mit klaren Grenzen. Nur eine davon ist das eigentliche Produkt; die übrigen existieren, um ihr eine Ausführungsumgebung zu geben.
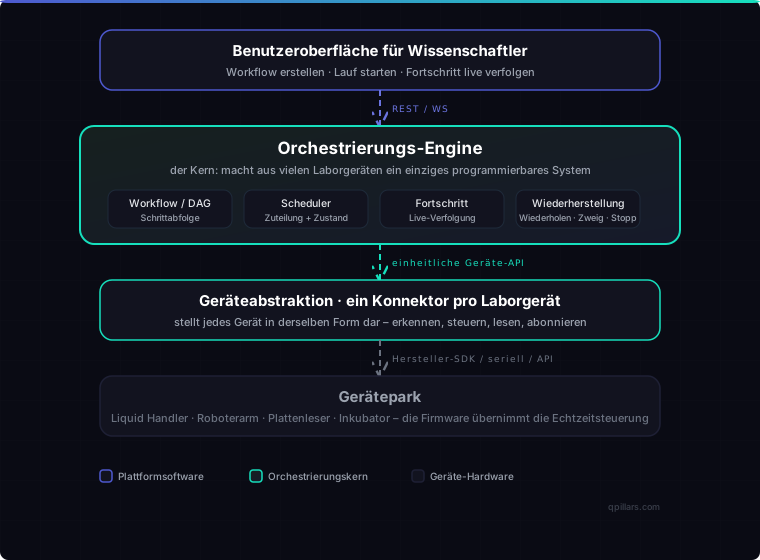
Diagramm 2: Die zu bauenden Schichten, mit der Orchestrierungs-Engine als Kern.
- Benutzeroberfläche für Wissenschaftlerinnen und Wissenschaftler – einen Workflow erstellen, einen Lauf starten, den Fortschritt live verfolgen. Kommuniziert über einfaches REST und WebSocket, ohne Geräteprotokoll.
- Orchestrierungs-Engine – der Kern: Workflow-Sequenzierung, Planung, Fortschrittsverfolgung, Fehlerbehebung.
- Geräteabstraktion – ein Konnektor pro Gerät, jeder mit derselben Form: erkennen, befehlen, lesen, abonnieren.
- Gerätepark – Firmware, die die Echtzeitsteuerung übernimmt. Ihre Plattform ist überwachend, niemals echtzeitfähig.
Die Regel, die sich später auszahlt: Die Engine sollte immer nur eine einzige Geräteform sehen. Verlagern Sie jeden Herstellerunterschied in die Konnektorschicht, damit er die Schleife nie erreicht.
Schritt 2: Den Kern als Ausführungsschleife bauen
Die Arbeitseinheit ist nicht ein Befehl, sondern ein Workflow – ein Graph aus Schritten mit Abhängigkeiten und Verzweigungen. Bauen Sie die Engine als Schleife, die diesen Graphen durchläuft.
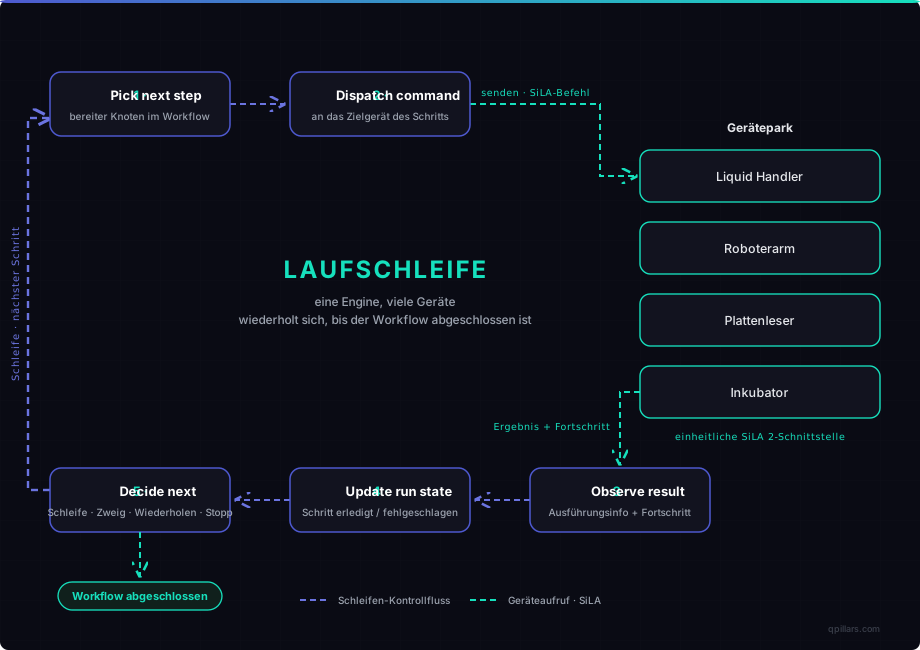
Diagramm 3: Die zu bauende Ausführungsschleife. Eine Engine, viele Geräte.
Ein Durchlauf, fünf Schritte:
- Den nächsten ausführbereiten Schritt wählen – den nächsten DAG-Knoten, dessen Abhängigkeiten erfüllt sind, sodass die Auswahl ein Nachschlagen ist und kein Raten.
- Den Befehl zur Ausführung übergeben an das Zielgerät des Schritts. Mit einer einheitlichen Schnittstelle ist «diesen Befehl starten» auf jedem Gerät derselbe Aufruf.
- Ergebnis und Fortschritt beobachten. Lang laufende Schritte streamen während der Ausführung Ausführungsinformationen zurück, sodass Schleife und Benutzeroberfläche Fortschritt sehen statt einer eingefrorenen Schaltfläche.
- Den Laufzustand aktualisieren. Den Schritt als erledigt oder fehlgeschlagen markieren, Ausgaben erfassen, den Graphen weiterführen. Persistieren Sie dies – ein Lauf, der einen Neustart nicht übersteht, ist eine Demo.
- Entscheiden, was als Nächstes kommt – wiederholen, anhand eines Ergebnisses verzweigen, einen vorübergehenden Fehler erneut versuchen oder anhalten. Wenn der Graph abgearbeitet ist, ist der Lauf abgeschlossen.
Die Schritte 2 und 3 sind über alle Geräte hinweg identisch, und genau darauf kommt es an. Würden Geräte unterschiedliche Verben für «starten», «ist es fertig» und «was ist schiefgelaufen» anbieten, würde sich die Schleife in herstellerspezifische Zweige aufspalten und verkommen. Das erzwingt die nächste Entscheidung.
Schritt 3: Eine einheitliche Geräteschnittstelle wählen (wir verwenden SiLA 2)
Diese Entscheidung bestimmt, ob der Aufbau gelingt. Wählen Sie eine Standardschnittstelle, die jedes Gerät bereitstellt, und zwar selbstbeschreibend, damit die Engine ein Gerät ansteuern kann, das sie noch nie gesehen hat.
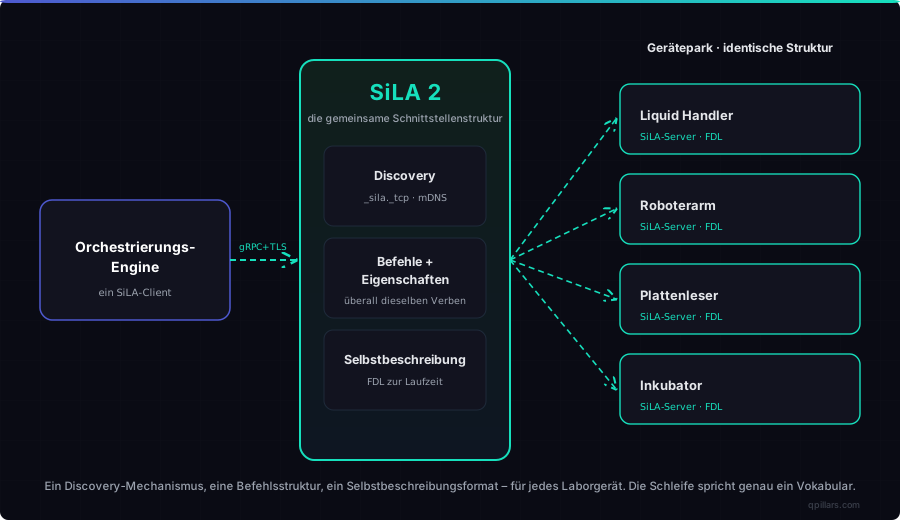
Diagramm 4: Die Schnittstellenentscheidung. Jedes Gerät weist dieselbe SiLA-Server-Form auf.
Bei SiLA 2 stellt ein Server ein oder mehrere Features bereit – typisierte Service-Schnittstellen –, die jeweils aus einer Menge von Commands (Funktionen, die der Client aufruft) und Properties (typisierten Werten, die er liest) bestehen. Commands und Properties können observable sein und Zwischenwerte streamen – so gelangt der Fortschritt in Ihre Schleife. Jedes Feature wird durch eine XML-Datei in FDL (Feature Definition Language) beschrieben, die der Client zur Laufzeit herunterlädt und liest. Dank dieser Selbstbeschreibung kann Ihre Engine gegen eine einzige Form planen, verfolgen und Fehler beheben und sich an ein Gerät binden, gegen das sie nie kompiliert wurde. Bauen Sie gegen den Standard, nicht gegen jeden einzelnen Hersteller.
Schritt 4: Zuerst die Erkennung lösen – sie bestimmt Ihr Deployment
Die Geräteerkennung wirkt wie ein Detail, legt aber stillschweigend Ihre gesamte Deployment-Topologie fest. Entscheiden Sie sie daher frühzeitig.
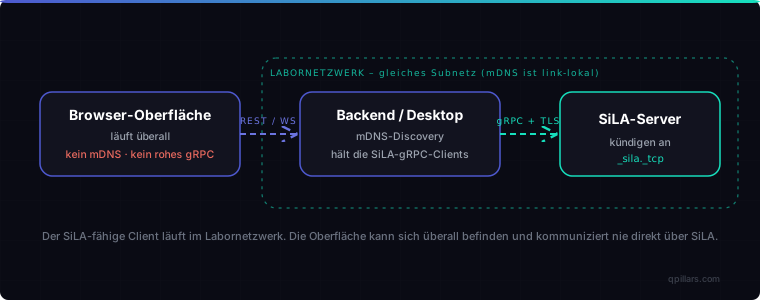
Diagramm 5: Die Erkennung und das laborseitige Backend, das Sie bauen müssen. SiLA-Server kündigen sich über mDNS unter _sila._tcp an; ein Prozess im Labornetzwerk hört mit, führt eine aktuelle Geräteliste und hält die gRPC-Clients.
Zwei Einschränkungen, um die herum Sie entwerfen müssen:
- mDNS ist link-lokal. Die Erkennung erreicht nur dasselbe Subnetz, daher muss der Prozess, der die Geräte erkennt und die SiLA-Clients hält, im Labornetzwerk laufen. Aus der Cloud lassen sich Geräte nicht erkennen.
- Browser sprechen kein SiLA. Eine Webseite kann weder mDNS ausführen noch das rohe gRPC über HTTP/2 öffnen, das SiLA voraussetzt. Legen Sie den SiLA-Client in ein kleines laborseitiges Backend; die Benutzeroberfläche kann es von überall über REST und WebSocket erreichen.
Damit ergeben sich zwei Möglichkeiten, dieselbe Architektur bereitzustellen: eine Web-App mit einem Backend-Dienst auf einem Laborrechner oder eine Desktop-App, die das Backend mitbringt. So oder so bauen Sie das Backend – eine reine Browser-App, die direkt mit Geräten kommuniziert, kann physisch nicht funktionieren.
Schritt 5: Den Handshake pro Gerät implementieren
Bauen Sie eine generische Bindungssequenz und führen Sie sie für jedes Gerät aus, ob von einem bekannten Hersteller oder noch nie gesehen.
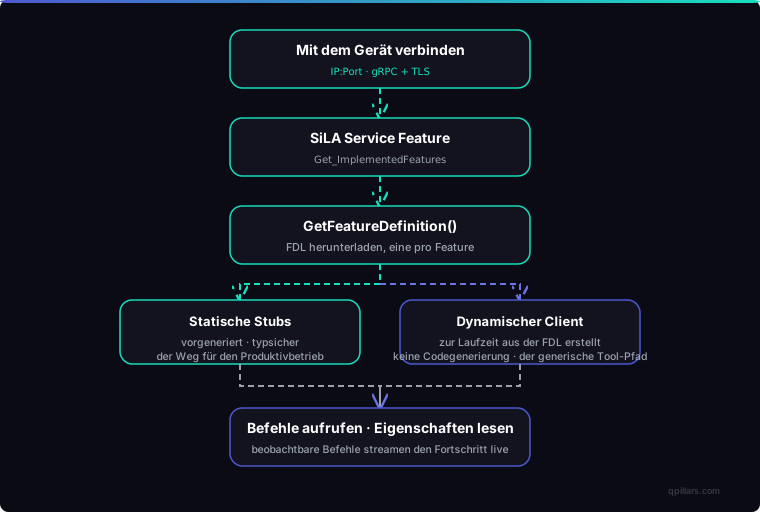
Diagramm 6: Der zu implementierende Handshake, einmal pro Gerät ausgeführt.
Verbinden über einen mit TLS gesicherten gRPC-Kanal. Selbstbeschreibung: Jeder SiLA-Server implementiert das obligatorische SiLA Service Feature. Rufen Sie also Get_ImplementedFeatures und anschliessend GetFeatureDefinition auf, um die FDL jedes Features herunterzuladen – nach diesem Roundtrip kennen Sie den vollständigen Vertrag, ohne vorher etwas über das Gerät zu wissen. Binden entweder mit statischen Stubs, die zur Build-Zeit aus der FDL vorgeneriert werden (typsicher, für einen bekannten Gerätepark), oder mit einem dynamischen Client, der zur Laufzeit aus der heruntergeladenen FDL erstellt wird (ohne Codegenerierung, für ein Gerät, gegen das Sie nie kompiliert haben); beide stimmen im Wire-Format Byte für Byte überein, sodass Sie sie kombinieren können. Aufrufen von Commands und Lesen von Properties – und für eine lange Messung liefert ein Observable Command eine Ausführungs-UUID zurück, streamt während der Ausführung den Fortschritt und liefert anschliessend das Ergebnis, das Sie direkt an die Benutzeroberfläche durchreichen.
Schritt 6: Schnittstellen generieren, nicht von Hand schreiben
Ihre Plattform ist nur dann interoperabel, wenn Sie das Wire-Format nie von Hand schreiben. Generieren Sie es, damit Kompatibilität eine Eigenschaft des Builds ist.
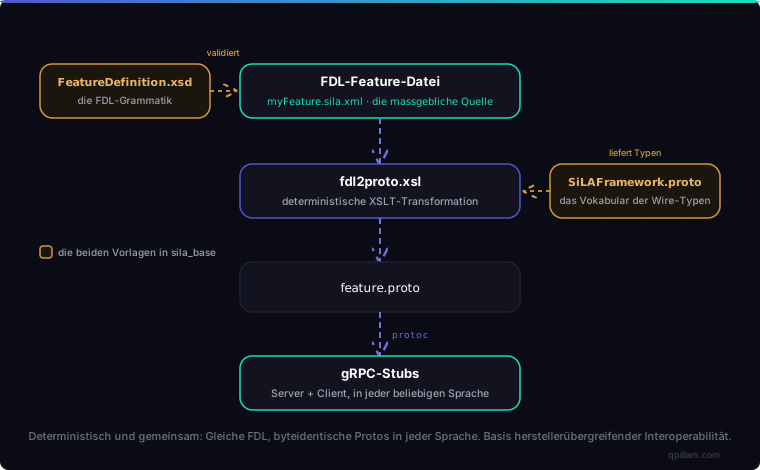
Diagramm 7: Die Generierungspipeline – der eigentliche Grund, warum ein .NET-Server und ein Python-Client interoperieren.
Jede Schnittstelle beginnt als FDL-Datei, die die Commands, Properties, Typen, Constraints und Fehler eines Features beschreibt. Zwei Masterdateien steuern dies: FeatureDefinition.xsd, die Grammatik, gegen die Sie jede FDL validieren, und SiLAFramework.proto, das Vokabular der Basistypen (Boolean, Integer, Real, String, Binary, Date, Time, Timestamp). Eine deterministische XSLT-Transformation, fdl2proto.xsl, wandelt die FDL in eine .proto-Datei um, und protoc kompiliert diese zu gRPC-Stubs. Weil die Transformation deterministisch und gemeinsam genutzt ist, leitet jede Implementierung aus derselben FDL eine byte-identische proto-Datei ab – deshalb interoperieren Geräte beliebiger Hersteller.
Ein Vorbehalt: Die proto-Datei ist eine verlustbehaftete Projektion. Constraints, Beschreibungen und strukturierte Fehler sind in der FDL enthalten, nicht in der proto-Datei. Behandeln Sie daher die FDL als massgebliche Quelle – deshalb laden Clients sie zur Laufzeit herunter, statt sich allein auf die proto-Datei zu verlassen.
Schritt 7: Die Einbindung beschleunigen
Ihre Plattform ist nur so breit wie die Geräte, die sie abdeckt, und der Engpass ist das Schreiben eines Konnektors pro Gerät. Der Hebel: Viele moderne Geräte stellen bereits eine REST-API mit einer OpenAPI-Spezifikation bereit, und Sie können diese Spezifikation mechanisch in einen SiLA-Treiber umwandeln.
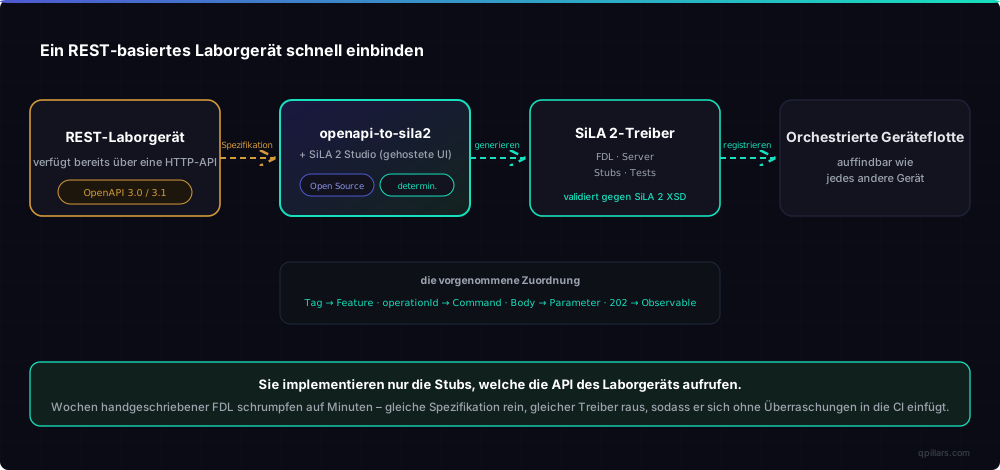
Diagramm 8: Den Engpass pro Gerät mit openapi-to-sila2 beseitigen.
openapi-to-sila2 (Open Source) stellt der oben beschriebenen Generierungspipeline eine Stufe von OpenAPI zu FDL voran. Richten Sie es auf die OpenAPI-3.0- oder -3.1-Spezifikation eines Geräts, und es generiert ein lauffähiges SiLA-2-Treibergerüst – FDL, Server, Stubs und Tests –, validiert gegen das SiLA-2-XSD. Die Zuordnung ist mechanisch: Jeder Tag wird zu einem Feature, jede operationId zu einem Command, der Request Body zu den Parametern des Commands und eine lang laufende Operation (202 Accepted) zu einem Observable Command. Sie implementieren nur die Stubs, die die API des Geräts aufrufen. Damit werden aus Wochen handgeschriebener FDL Minuten, und weil der Vorgang deterministisch ist, können Sie ihn in Ihre CI einbinden.
Möchten Sie lieber eine Spezifikation einfügen und die Zuordnung in einer Prüfansicht bearbeiten? Dafür gibt es ein gehostetes Frontend, SiLA 2 Studio – siehe SiLA 2 Studio: Von OpenAPI zum SiLA-2-Treiber in zwei Minuten. Warum REST und SiLA nicht direkt miteinander kommunizieren können, erfahren Sie unter Warum REST-APIs und SiLA 2 nicht miteinander sprechen.
Was Sie als Nächstes bauen: Daten- und ELN-Integration
Dieser Leitfaden endet bewusst bei der Steuerungsschicht. Der Assay läuft, das Ergebnis kommt zurück – doch wohin geht es, und wie gelangen seine Metadaten in die Systeme, mit denen Wissenschaftlerinnen und Wissenschaftler täglich arbeiten? Das ist die Datenschicht: ELN- und LIMS-Integration. Ein anderes Problem mit eigenen Rahmenbedingungen und einem eigenen Beitrag – der als Nächstes folgt.
Fazit
Bauen Sie die Plattform in der Reihenfolge, in der die Entscheidungen verbindlich werden: Verhindern Sie, dass die Integrationskosten wachsen, gliedern Sie vier Schichten, bauen Sie die Engine als Ausführungsschleife über einen persistierten Workflow-DAG, wählen Sie eine einheitliche, selbstbeschreibende Schnittstelle, damit die Schleife eine einzige Form sieht, lösen Sie zuerst die Erkennung, implementieren Sie einen generischen Handshake, generieren Sie das Wire-Format und machen Sie die Einbindung mechanisch. Die Schleife ist der leicht zu beschreibende Teil; der Rest macht sie real – eine Schnittstelle, gefunden durch Erkennung, deterministisch generiert, schnell eingebunden. SiLA 2 liefert Ihnen die Einheitlichkeit, und openapi-to-sila2 macht das Hinzufügen des nächsten Geräts zu einer Sache von Minuten.
Wichtigste Erkenntnisse
- Eine Orchestrierungsplattform für die Laborautomatisierung besteht aus vier Schichten – Benutzeroberfläche, Engine, Geräteabstraktion, Gerätepark –, und nur die Engine ist schwierig zu bauen.
- Bauen Sie die Engine als Ausführungsschleife über einen Workflow-DAG: den nächsten ausführbereiten Schritt wählen, zur Ausführung übergeben, Ergebnis und Fortschritt beobachten, den persistierten Zustand aktualisieren, entscheiden, was als Nächstes kommt.
- Die entscheidende Wahl ist die Geräteschnittstelle. Wählen Sie einen einheitlichen, selbstbeschreibenden Standard, damit die Schleife eine einzige Form sieht; wir verwenden SiLA 2.
- Lösen Sie die Erkennung frühzeitig. mDNS (
_sila._tcp) ist link-lokal, was ein laborseitiges Backend erzwingt; die Benutzeroberfläche kann über REST überall laufen. - Generieren Sie das Wire-Format mit der deterministischen Transformation
fdl2proto.xslund den beiden Masterdateien; schreiben Sie es nie von Hand, damit die herstellerübergreifende Interoperabilität durch den Build gewährleistet ist. - Machen Sie die Einbindung mechanisch:
openapi-to-sila2und SiLA 2 Studio wandeln die OpenAPI-Spezifikation eines Geräts in ein lauffähiges SiLA-Treibergerüst um, sodass REST-basierte Geräte schnell in den Gerätepark aufgenommen werden.
Häufig gestellte Fragen
Wie baut man eine Orchestrierungsplattform für die Laborautomatisierung?
Bauen Sie vier Schichten – eine Benutzeroberfläche, eine Orchestrierungs-Engine, eine Geräteabstraktionsschicht und den Gerätepark – und konzentrieren Sie Ihren Aufwand auf die Engine. Die Engine führt eine Steuerungsschleife über einen Workflow-Graphen aus: den nächsten ausführbereiten Schritt wählen, einen Befehl zur Ausführung an das Zielgerät übergeben, Ergebnis und Fortschritt beobachten, den persistierten Laufzustand aktualisieren und entscheiden, was als Nächstes ausgeführt wird, bis der Lauf abgeschlossen ist. Die Entscheidung, die über Erfolg oder Misserfolg bestimmt, ist die Wahl einer einheitlichen, selbstbeschreibenden Geräteschnittstelle, damit die Schleife eine einzige Form sieht.
Was ist der schwierigste Teil beim Bau einer Plattform zur Geräteorchestrierung?
Dafür zu sorgen, dass jedes Gerät für die Engine gleich aussieht. Geräte werden mit inkompatiblen Schnittstellen ausgeliefert – Hersteller-SDKs, proprietäre Sockets, REST, seriell –, und wenn diese Unterschiede die Orchestrierungsschleife erreichen, spaltet sie sich in herstellerspezifische Sonderfälle auf und wird unwartbar. Die Lösung besteht darin, sich auf eine Standardschnittstelle festzulegen (wir verwenden SiLA 2) und jeden Herstellerunterschied in die Konnektorschicht zu verlagern.
Warum braucht eine Orchestrierungsplattform ein Backend im Labornetzwerk?
Wegen Erkennung und Transport. Die SiLA-Erkennung verwendet mDNS, das link-lokal ist und nur dasselbe Subnetz erreicht, und Browser können weder mDNS ausführen noch das rohe gRPC über HTTP/2 öffnen, das SiLA voraussetzt. Daher muss der SiLA-Client in einem Prozess im Labornetzwerk laufen, und die Benutzeroberfläche kommuniziert mit ihm über REST und WebSocket. Sie können dieses Backend als Dienst auf einem Laborrechner oder gebündelt in einer Desktop-App bereitstellen.
Wie fügt man der Plattform schnell ein neues Gerät hinzu?
Wenn das Gerät eine REST-API hat, generieren Sie den Konnektor, statt ihn zu schreiben. Richten Sie openapi-to-sila2 oder das gehostete SiLA 2 Studio auf dessen OpenAPI-3.0- oder -3.1-Spezifikation, und es erzeugt ein lauffähiges SiLA-2-Treibergerüst – FDL, Server, Stubs und Tests –, validiert gegen das SiLA-2-XSD. Sie implementieren nur die Stubs, die die API des Geräts aufrufen. Der Vorgang ist deterministisch und lässt sich daher sauber in die CI integrieren.
Iacob ist technischer Leiter bei QPillars, einem Unternehmen mit Sitz in Zürich, das intelligente Software-Infrastruktur für Laborgeräte in den Life Sciences entwickelt. Wir bauen herstellerneutrale Orchestrierungsplattformen – Erkennungs-Backends, Orchestrierungs-Engines und Konnektoren – und pflegen den Open-Source-Generator openapi-to-sila2. Wenn Sie eine Orchestrierungsplattform für die Laborautomatisierung bauen oder beschaffen möchten, kontaktieren Sie uns unter iacob@qpillars.com.
Technischer Leiter und Mitgründer bei QPillars
Spezialisiert auf Laborautomatisierung – von der praktischen Gerätesteuerung und Flüssigkeitshandhabung bis zur KI-gestützten Orchestrierung von Protokollen.