
Agentische KI für die Laborautomatisierung: Warum ein Laborgerät nicht einfach ein weiteres Tool ist
Agentische KI für die Laborautomatisierung: Warum ein Laborgerät nicht einfach ein weiteres Tool ist
Agentische KI für die Laborautomatisierung scheitert an einer Grenze, die gewöhnliche toolnutzende Agenten nie erreichen: an der Agent-zu-Gerät-Schnittstelle. Dort bewegt eine einzige Aktion echte Flüssigkeit, verbraucht eine echte Probe oder heizt einen echten Reaktor auf. Protokolle wie das Model Context Protocol (MCP) standardisieren, wie ein Agent ein Software-Tool aufruft. Ein Laborgerät ist jedoch eine zustandsbehaftete, sicherheitskritische und physisch verkörperte Ressource – keine zustandslose Funktion, die Sie beliebig und ohne Kosten wiederholen können. Agenten funktionieren im Labor bei jenen Teams, die diese Schnittstelle als eigenständiges technisches Problem behandeln.
Update September 2026: Die Forschungsvorschau des Model Hardware Standard macht diese Grenze auf neue Weise greifbar. Unsere MHS-Analyse für die Laborautomatisierung stellt die vorgeschlagene Treiberschicht MCP, SiLA 2 und OPC UA LADS gegenüber und zeigt, welche Kontrollmechanismen deterministisch bleiben müssen.
Das Geld und die öffentliche Erzählung rund um autonome Wissenschaft sind bereits da. Lila Sciences hat insgesamt 550 Mio. US-Dollar eingeworben, um «AI Science Factories» aufzubauen, Periodic Labs erhielt eine Seed-Finanzierung von 300 Mio. US-Dollar, und die Einschätzung der MIT Technology Review vom Dezember 2025 war unmissverständlich: KI-gestützte Entdeckung muss in die reale Welt vordringen. Technisch bedeutet das Vordringen in die reale Welt genau eines: Agenten müssen physische Geräte zuverlässig bedienen können. Dieser Beitrag behandelt die Schicht, in der das tatsächlich geschieht.
Das Wichtigste in Kürze
- Agentische KI für die Laborautomatisierung hat drei Schnittstellen – Agent-zu-Tool, Agent-zu-Agent und Agent-zu-Gerät. Für die ersten beiden gibt es Protokolle. An der dritten scheitern die meisten Projekte stillschweigend.
- Ein Laborgerät ist kein Tool. Es ist zustandsbehaftet, exklusiv gesperrt, sicherheitskritisch und physisch irreversibel. Wird es als zustandslose Funktion modelliert, ist das die Grundursache für unsicheres oder fragiles Agentenverhalten.
- Das Zuverlässigkeitsproblem ist ein Softwareproblem, kein Modellproblem. Ein grösseres Modell behebt keinen Agenten, der Hardware direkt aus Freitextausgaben ansteuern kann.
- MCP und SiLA 2 ergänzen einander, statt zu konkurrieren – MCP macht Fähigkeiten für den Agenten verfügbar, SiLA 2 definiert eine deterministische Gerätesteuerung. Keines von beiden schliesst die Sicherheitslücke für sich allein.
- Das bewährte Muster: vorschlagen, validieren, dann ausführen. Natürliche Sprache steuert Hardware nie direkt; jede physische Aktion durchläuft einen validierten, strukturierten und überprüfbaren Aufruf.
- Evaluation kommt vor Autonomie. Jede höhere Autonomiestufe verdienen Sie sich, indem Sie den Agenten an der physischen Welt messen – nicht, indem Sie der Demo vertrauen.
Die drei Schnittstellen eines agentischen Laborsystems
Ein Agent, der echte Arbeit leistet, interagiert mit drei verschiedenen Arten von Gegenstellen, und jede davon ist eine eigene technische Schnittstelle. Eine Übersichtsarbeit aus dem Jahr 2025 zu Interoperabilitätsprotokollen für Agenten beschreibt das Ökosystem auf diese Weise, und ein Paper vom Juni 2026, LAP: An Agent-to-Instrument Protocol for Autonomous Science, schärft dies zu der Unterscheidung, auf die es im Labor ankommt:
- Die Agent-zu-Tool-Schnittstelle. Der Agent ruft eine Softwarefunktion auf – eine Datenbankabfrage, eine Berechnung, eine Websuche. MCP standardisiert diese Schnittstelle. Tool-Aufrufe sind zustandslos und lassen sich günstig wiederholen.
- Die Agent-zu-Agent-Schnittstelle. Der Agent delegiert an einen anderen Agenten. Protokolle wie Googles A2A standardisieren diese Schnittstelle.
- Die Agent-zu-Gerät-Schnittstelle. Der Agent erteilt einer physischen Maschine Befehle. Wie es die LAP-Autoren formulieren, standardisiert MCP die Agent-zu-Tool-Schnittstelle und A2A die Agent-zu-Agent-Schnittstelle, «doch keines von beiden modelliert die Agent-zu-Gerät-Schnittstelle, an der Operationen zustandsbehaftet, sicherheitskritisch, exklusiv gesperrt und physisch verkörpert sind».
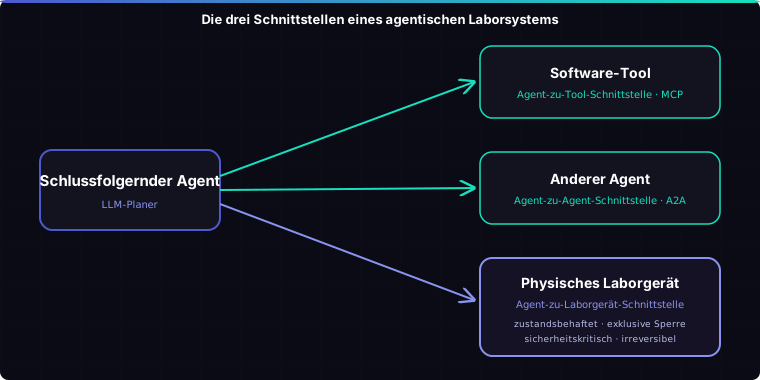
Das obige Diagramm zeigt denselben schlussfolgernden Agenten, der allen drei Schnittstellen gleichzeitig gegenübersteht. Die ersten beiden sind gut erschlossen: Der archetypische Agent ChemCrow verband GPT-4 bereits 2024 mit achtzehn Chemie-Tools, und das Fachgebiet hat sich seither, wie ein Frontiers-Review beschreibt, «vom Single-Shot-Prompting hin zu agentischen Ketten entwickelt, die Benutzerziele in Abfolgen von Tool-Aufrufen zerlegen». An der dritten Schnittstelle enden die Demos und beginnt die eigentliche Ingenieursarbeit, denn jedes Team, das sie erreicht, baut die Verbindung zwischen dem schlussfolgernden Agenten und dem physischen Gerät von Grund auf neu.
Warum ein Laborgerät kein Tool ist
Der Unterschied ist nicht bloss oberflächlich. Vier Eigenschaften unterscheiden ein Gerät von einem Tool-Aufruf, und jede davon widerlegt eine Annahme, auf der Agenten-Frameworks aufbauen.
Es ist zustandsbehaftet. Ein Liquid Handler hat Spitzen geladen oder nicht, ein Deck konfiguriert oder nicht, eine Reservierung aktiv oder nicht. Derselbe Befehl führt zum Erfolg oder zerstört einen Lauf – je nach physischem Zustand, den das Modell in seinem Kontextfenster nicht sehen kann.
Es ist exklusiv. Zwei Agenten können nicht gleichzeitig in dieselbe Vertiefung pipettieren. Geräte benötigen Reservierung und Sperrung – ein Konzept, das in zustandslosen Tool-Protokollen fehlt, in denen parallele Aufrufe nichts kosten.
Es ist sicherheitskritisch. Eine falsche Temperatur, ein falsches Aspirationsvolumen, eine Kollision – all dies beschädigt Hardware, ruiniert Proben oder gefährdet eine Bedienperson. Eine kostenlose Wiederholung gibt es nicht.
Es ist physisch irreversibel. Eine verbrauchte Probe lässt sich nicht zurückholen, ein gemischtes Reagenz nicht entmischen. Während ein fehlgeschlagener Tool-Aufruf einige Tokens kostet, kann ein fehlgeschlagener Geräteaufruf einen Tag Arbeit im Nasslabor und eine unersetzliche Probe kosten.
Jede dieser Eigenschaften würde für sich allein eine eigene Steuerungsschicht rechtfertigen. Zusammengenommen bedeuten sie: Ein Agent, der ein Gerät als «einfach ein weiteres Tool» behandelt, ist nicht vereinfacht – er ist unsicher. Es ist dieselbe Lehre, die aus jahrelanger Entwicklung der Gerätesteuerung für Diagnostikplattformen in klinischer Qualität stammt: Der schwierige Teil war nie der Normalfall, sondern der Zustand, die Verriegelungen und die Fehlermodi.
Was tatsächlich versagt: Freitextausgabe trifft auf echte Hardware
Der Fehlermodus ist spezifisch. Bei einem naiven Agenten wird darauf vertraut, dass die Ausgabe des Modells die nächste Aktion steuert. Das ist akzeptabel, wenn die Aktion eine Datenbankabfrage ist. Es ist nicht akzeptabel, wenn die Aktion einen Roboterarm bewegt.
Für die deterministische Hälfte des Problems gibt es Standards. SiLA 2, der führende offene Standard für die Gerätekonnektivität, «basiert auf offenen, gut etablierten Kommunikationsprotokollen und definiert darauf eine schlanke domänenspezifische Schicht» – gRPC und Protocol Buffers, mit einer Feature Definition Language, die die typisierten Fähigkeiten jedes Geräts beschreibt. Der Standard überzeugt bei der deterministischen Orchestrierung: Eine Workflow-Engine kann jeden Befehl auflisten, den ein Gerät akzeptiert.
SiLA 2 wurde jedoch, wie OPC-UA und SCPI, für einen deterministischen Client entwickelt, nicht für einen probabilistischen Agenten. Wie die LAP-Analyse festhält, sind seine Schemata «statisch und zur Entwurfszeit definiert; es gibt keine Aushandlung von Fähigkeiten zur Laufzeit und keinen Mechanismus, um physische Sicherheitsgrenzen oder Gefahrenklassifizierungen pro Fähigkeit auszudrücken». Mit anderen Worten: Der Standard sagt einem Agenten, was ein Gerät kann, aber nichts darüber, was im Moment sicher ist oder wie sich dies zur Laufzeit aushandeln lässt. Diese Lücke – zwischen einer maschinenlesbaren Fähigkeit und einer sicheren, situationsgerechten Aktion – ist genau die Stelle, an der ein Agent eine Steuerungsschicht benötigt, und genau das, was ein generisches Tool-Protokoll nicht bietet.
Eine Steuerungsschicht, mit der Agenten Geräte bedienen können
Diese Lücke schliessen Sie nicht mit einem besseren Prompt. Sie schliessen sie mit einer Architektur, die natürliche Sprache niemals direkt mit Hardware in Berührung kommen lässt. Fünf Prinzipien, mühsam erarbeitet, definieren, was eine Steuerungsschicht für die Agent-zu-Gerät-Schnittstelle leisten muss. Keines davon ist modellspezifisch.
-
Nur über validierte, strukturierte Aufrufe ausführen. Hardware wird nie aus rohen Modellausgaben angesteuert. Die in Freitext formulierte Absicht des Agenten wird in eine typisierte, schemageprüfte Aktion überführt, und nur diese validierte Aktion erreicht das Gerät. Die LAP-Autoren formulieren die Regel unmissverständlich: Hardware wird «immer nur über einen validierten strukturierten Aufruf betätigt, niemals direkt aus der Modellausgabe».
-
Vorschlagen, dann bestätigen. Ein in Freitext formuliertes Ziel wird zu einem strukturierten, für Menschen lesbaren Vorschlag, bevor sich irgendetwas bewegt. Bei folgenreichen Schritten ist dieser Vorschlag eine Freigabeschranke – ein Punkt, an dem eine Bedienperson genehmigt, und keine Entscheidung, die in der Gedankenkette eines Modells verborgen ist. Dies ist die praktische Form von Human-in-the-Loop für physische Systeme.
-
Reservieren und sperren. Exklusiver Zugriff ist ein grundlegendes Primitiv. Ein Agent belegt ein Gerät, hält es für die Dauer eines Schritts und gibt es wieder frei – so wird Nebenläufigkeit nie zu einer Kollision.
-
Physikalisch typisierte Ergebnisse zurückgeben. Ein Messwert ist keine Zeichenkette. Er trägt Einheiten, Kalibrierungskontext und Unsicherheit, sodass der Agent über eine reale Grösse schlussfolgert und nicht über eine Zahl, die zufällig plausibel aussieht.
-
Evaluieren, bevor Sie vertrauen. Jede Erhöhung der Autonomie wird durch Messung an der physischen Welt verdient – Erfolgsquote, Fehlermodi, Wiederherstellungsverhalten –, nicht durch eine überzeugende Demo. Ein kürzlich vorgestellter Agent, der über eine MCP-Schnittstelle einen vollständigen Zyklus über ein System zur Orchestrierung von Experimenten ausführte, meldete eine Erfolgsquote von 97 % beim ersten Versuch über 65 Durchläufe; aussagekräftig ist diese Zahl nur, weil jemand die Durchläufe definiert und die Fehlschläge gezählt hat.
Dies ist die Schicht, die QPillars entwickelt: die Infrastruktur, mit der KI-Agenten Laborgeräte bedienen können – sicher und zuverlässig, angesiedelt zwischen dem schlussfolgernden Agenten und der physischen Maschine. Die obigen Prinzipien beschreiben die Form des Problems. Wie Sie Reservierung, Validierung und Evaluation für einen bestimmten Gerätepark umsetzen, ist der Ort der eigentlichen Ingenieursarbeit – und genau dort lässt Sie ein generisches Agenten-Framework allein. Zur angrenzenden Frage der Standards haben wir separat darüber geschrieben, wie Sie KI-Agenten mit MCP an Geräte anbinden und wie Sie zuverlässige KI-Agenten für Laborgeräte entwickeln.
Wo Sie auf der Autonomieleiter stehen
Nichts davon erfordert vom ersten Tag an volle Autonomie, und das sollte es auch nicht. Ginkgo Bioworks hat einen nützlichen Rahmen veröffentlicht – sechs Levels of Laboratory Autonomy (LoLA), Stufen 0 bis 5, ausdrücklich nach dem Vorbild der Skala für selbstfahrende Fahrzeuge gestaltet und mit einer klaren Trennlinie zwischen Automatisierung («Ausführung vordefinierter Protokolle») und Autonomie («Entscheidungsfindung und Anpassung»).
Die meisten glaubwürdigen Systeme befinden sich heute auf Stufe 3, «Conditional Autonomy» (bedingte Autonomie), auf der, in den Worten von Ginkgo, «KI-Agenten mit natürlicher Sprache und Software zum Debugging von Protokollen die Übertragung experimenteller Pläne an das autonome Labor ohne menschliche Programmierung ermöglichen». Das ist ein realistisches und wertvolles Ziel: Eine Wissenschaftlerin oder ein Wissenschaftler beschreibt die Absicht in natürlicher Sprache, der Agent plant und führt aus, und ein Mensch bleibt bei den folgenreichen Entscheidungen eingebunden. Um dorthin zu gelangen, braucht es kein klügeres Modell. Es braucht eine Steuerungsschicht an der Agent-zu-Gerät-Schnittstelle, die ihre Aufgabe erfüllt. Dieselbe evidenzbasierte Sicht auf den breiteren Markt haben wir in Self-Driving Labs 2026 – was funktioniert und was Hype ist eingenommen.
Häufig gestellte Fragen
Was ist die Agent-zu-Gerät-Schnittstelle?
Es ist die Grenze, an der ein KI-Agent einem physischen Laborgerät statt einem Software-Tool Befehle erteilt. Anders als ein Tool-Aufruf ist eine Geräteaktion zustandsbehaftet, exklusiv, sicherheitskritisch und physisch irreversibel. Sie benötigt eine eigene Steuerungsschicht – Reservierung, Validierung und Sicherheitsbegrenzung –, die generische Agentenprotokolle wie MCP für sich allein nicht bereitstellen.
Kann ich einfach MCP verwenden, damit ein KI-Agent ein Laborgerät steuert?
MCP ist der richtige Weg, um die Fähigkeiten eines Geräts für einen Agenten verfügbar zu machen, und es ist eine solide Grundlage. MCP standardisiert jedoch die Agent-zu-Tool-Schnittstelle; es modelliert weder den Gerätezustand noch exklusive Sperrung oder Sicherheitsgrenzen pro Aktion. Sie benötigen weiterhin eine Steuerungsschicht, die jede Aktion validiert und niemals zulässt, dass Freitextausgaben des Modells Hardware direkt ansteuern.
Reicht SiLA 2 für agentische Laborautomatisierung aus?
SiLA 2 eignet sich hervorragend für die deterministische Gerätesteuerung und maschinenlesbare Fähigkeiten und ist der ausgereifteste offene Standard für diese Aufgabe. Seine Einschränkung für Agenten besteht darin, dass seine Schemata statisch und zur Entwurfszeit festgelegt sind – ohne Aushandlung von Fähigkeiten zur Laufzeit und ohne Gefahrenklassifizierung pro Fähigkeit. Er beantwortet, was ein Gerät kann, nicht aber, was im Moment sicher ist – und genau das braucht ein Agent.
Warum scheitern Agenten für die Laborautomatisierung, selbst wenn das Sprachmodell sehr leistungsfähig ist?
Weil Zuverlässigkeit an der Geräteschnittstelle ein Architekturproblem ist, kein Problem des Schlussfolgerns. Auch ein leistungsfähiges Modell richtet Schaden an, wenn seine Ausgabe Hardware direkt ansteuern kann, wenn keine Reservierung Kollisionen verhindert oder wenn Ergebnisse untypisiert sind. Die Lösung ist eine Steuerungsschicht, welche die Ausführung einschränkt, nicht ein grösseres Modell.
Wie halten Sie bei einem physischen KI-Agenten einen Menschen sicher in der Schleife?
Wandeln Sie die in Freitext formulierte Absicht des Agenten in einen strukturierten, für Menschen lesbaren Vorschlag um, bevor sich irgendetwas bewegt, und machen Sie diesen Vorschlag bei folgenreichen Schritten zu einer expliziten Freigabeschranke. Die Genehmigung bezieht sich dann auf eine validierte Aktion und nicht auf eine Entscheidung, die im Schlussfolgern des Modells verborgen ist – erst dadurch wird Human-in-the-Loop wirksam statt bloss kosmetisch.
Verfasst von Iacob Marian, Technischer Leiter und Mitgründer von QPillars, wo er die Infrastruktur entwickelt, mit der KI-Agenten Laborgeräte sicher und zuverlässig bedienen. Veröffentlicht am 2026-07-04.
Technischer Leiter und Mitgründer bei QPillars
Spezialisiert auf Laborautomatisierung – von der praktischen Gerätesteuerung und Flüssigkeitshandhabung bis zur KI-gestützten Orchestrierung von Protokollen.