
Selbstfahrende Labore 2026 - was tatsächlich funktioniert und was noch Hype ist
Selbstfahrende Labore 2026 - was tatsächlich funktioniert und was noch Hype ist
Jeder Anbieter von Laborautomatisierung behauptet inzwischen, ein «selbstfahrendes Labor» (Self-Driving Lab, SDL) anzubieten. Der Begriff ist so verwässert, dass er alles abdeckt - von einer Bayes'schen Optimierungsschleife an einem einzelnen Reaktor bis hin zu einer vollständig autonomen Roboteranlage, die 50 Geräte ohne menschliches Eingreifen betreibt. Der Nature-Beitrag vom März 2026 «Inside the 'self-driving' lab revolution» porträtierte die Flotte von 50 autonomen Robotern von Alan Aspuru-Guzik beim Acceleration Consortium - finanziert mit 200 Mio. Can$, dem grössten staatlichen Forschungszuschuss, der je an eine kanadische Universität vergeben wurde. Gleichzeitig lancierte Ginkgo Bioworks sein Cloud Lab, Automata sammelte 45 Mio. $ ein, um «das Betriebssystem für KI-fähige Labore» zu entwickeln, und Chemspeed ging eine Partnerschaft mit SciY ein, um eine herstellerunabhängige SDL-Plattform auszuliefern. Das Geld und die Ankündigungen sind real. Aber was funktioniert tatsächlich?
Dieser Beitrag trennt das Signal vom Rauschen. Wir untersuchen, welche Technologie für selbstfahrende Labore produktiv ausgeliefert wird, was reine Forschung bleibt und warum die Lücke zwischen skriptgesteuerter Automatisierung und echter Autonomie fast ausschliesslich ein Software- und kein Hardwareproblem ist.
Die wichtigsten Erkenntnisse
- Die meisten «selbstfahrenden Labore» befinden sich heute auf Stufe 2-3 einer fünfstufigen Autonomieskala - Optimierung im geschlossenen Regelkreis für eng begrenzte Aufgaben, keine universelle Autonomie
- Die Hardware ist nicht der Engpass - Roboter und Geräte sind leistungsfähig genug; was fehlt, ist die Software-Middleware, die sie zu einem intelligenten System verbindet
- Anfang 2026 wurden drei herstellerunabhängige SDL-Plattformen ausgeliefert - Chemspeed/SciY, Automata LINQ und Ginkgo Cloud Lab -, die jeweils unterschiedliche Schichten des Stacks adressieren
- GxP-Konformität ist lösbar, aber einschränkend - die gemeinsamen Guiding Principles of Good AI Practice in Drug Development von FDA und EMA (Januar 2026) bieten einen Rahmen, doch autonome Entscheidungen in regulierten Umgebungen erfordern weiterhin eine menschliche Freigabe
- MCP und SiLA2 sind komplementäre Standards, die bestimmen werden, wie Geräte in SDL-Architekturen kommunizieren - MCP für den Zugriff durch KI-Agenten, SiLA2 für die strukturierte Gerätesteuerung
- Labore, die jetzt in die Softwareschicht investieren - Geräte-APIs, Datenpipelines, digitale Zwillinge -, werden einen strukturellen Vorteil haben, wenn SDL-Plattformen bis 2027 ausreifen
Die Autonomieskala - wo SDLs tatsächlich stehen
Die Analogie zum selbstfahrenden Auto ist hier hilfreich. So wie SAE die Stufen 0-5 für die Fahrzeugautonomie definiert hat, haben Forschende eine entsprechende Skala für die Laborautomatisierung vorgeschlagen (Royal Society Open Science, 2025):
| Stufe | Beschreibung | Rolle des Menschen | Stand 2026 |
|---|---|---|---|
| 0 | Alles manuell | Alles | Noch verbreitet |
| 1 | Repetitive Aufgaben automatisiert | Bediener + Entscheidungsträger | Standardautomatisierung |
| 2 | Digitale Protokolle, maschineninterpretierbare Daten | Aufsicht + Ausnahmebehandlung | Hier stehen die meisten «SDLs» |
| 3 | Geschlossene DBTL-Zyklen, Anomalien werden gemeldet | Zielvorgabe + Anomaliebehebung | Führende SDLs |
| 4 | Vollständige robotische Ausführung + Routineanalyse | Nur Zielvorgabe | Für eng begrenzte Aufgaben demonstriert |
| 5 | Vollständig autonom | Keine | Existiert nicht |
Die ehrliche Einschätzung: Die überwiegende Mehrheit der als «selbstfahrende Labore» vermarkteten Systeme arbeitet auf Stufe 2, eine Handvoll erreicht Stufe 3. Stufe 4 wurde für robotisch einfache Chemieaufgaben in klar definierten Parameterräumen demonstriert. Stufe 5 bleibt ein Forschungsziel, keine technische Realität.
Das ist keine Kritik - Systeme der Stufen 2-3 liefern echten Mehrwert. Bayes'sche Optimierungsschleifen an automatisierten Reaktoren können chemische Räume 10- bis 100-mal schneller erkunden als manuelle Experimente. Aber eine Optimierung im geschlossenen Regelkreis an einem einzelnen Gerät als «selbstfahrendes Labor» zu bezeichnen, ist so, als würde man einen adaptiven Tempomaten «selbstfahrend» nennen.
Was 2026 tatsächlich ausgeliefert wird
Drei grosse Plattformankündigungen Anfang 2026 stehen für echten Fortschritt, wobei jede einen anderen Teil des SDL-Stacks adressiert.
Chemspeed + SciY - der herstellerunabhängige Stack
Die im Februar an der SLAS2026 angekündigte Partnerschaft von Chemspeed und SciY liefert, was viele Labore gefordert haben: eine offene, herstellerunabhängige SDL-Plattform, die Automatisierung, Analytik und KI-Orchestrierung integriert, ohne Sie an das Ökosystem eines einzelnen Herstellers zu binden.
Die Plattform beruht auf drei Säulen:
- Automatisierung von Chemspeed - modulare, herstellerunabhängige Gerätesteuerung mit deterministischer Ausführung
- Analytik von Bruker - NMR, IR/Raman, MS und Röntgen mit rückverfolgbaren quantitativen Daten (Chemspeed ist eine Tochtergesellschaft von Bruker)
- Daten-Backbone von SciY - FAIR-Datenerfassung, ontologiebasierte Semantik und Workflow-Orchestrierung
Das zentrale Unterscheidungsmerkmal ist das offene Daten-Backbone. SciY bietet eine herstellerunabhängige Datenintegration mit semantischer Annotation - das heisst, Daten von jedem beliebigen Gerät werden in ein abfragbares, KI-fähiges Format normalisiert. Das ist die Middleware-Schicht, die den meisten SDL-Implementierungen fehlt.
Was das bedeutet: Für Labore, die bereits Automatisierung von Chemspeed einsetzen, ist dies der produktionsreifste Weg zu einem echten SDL-Workflow. Die Darstellung als «sofort einsatzbereiter Full Stack» ist glaubwürdig, weil Chemspeed die physische Automatisierungsschicht bereits kontrolliert.
Automata LINQ - die Orchestrierungsschicht
Mit der Series-C-Finanzierungsrunde über 45 Mio. $ (Januar 2026, angeführt von Dimension mit strategischer Beteiligung von Danaher Ventures) positioniert Automata seine Plattform LINQ als Orchestrierungsschicht für Labore mit Geräten mehrerer Hersteller. LINQ ist eine Cloud-native Engine, mit der Labore mehrstufige experimentelle Prozesse über Geräte verschiedener Hersteller hinweg standardisieren und automatisieren können.
Die Beteiligung von Danaher ist strategisch bedeutsam. Danaher besitzt Beckman Coulter Life Sciences, und die gleichzeitig angekündigte Partnerschaft integriert die Geräte von Beckman für Liquid Handling, Genomik und Zellanalyse direkt in LINQ. Mit bereits fünf Top-Pharmaunternehmen als Kunden und Murali Venkatesan von Danaher im Verwaltungsrat hat Automata einen klaren Weg in den Unternehmensmarkt.
Was das bedeutet: LINQ schliesst die Orchestrierungslücke - die Verbindung von Geräten verschiedener Hersteller zu koordinierten Workflows. Es ist kein vollständiges SDL (keine KI-Entscheidungsengine), löst aber das praktische Problem der herstellerübergreifenden Gerätekoordination, das die meisten Labore daran hindert, autonome Workflows überhaupt in Angriff zu nehmen.
Ginkgo Cloud Lab - der Full Stack (für Biologika)
Ginkgo Bioworks hat im März 2026 das Cloud Lab lanciert - eine webbasierte Schnittstelle zu seiner autonomen Laborinfrastruktur in Boston. Dies ist die ambitionierteste derzeit in Betrieb befindliche SDL-Implementierung:
- Über 70 Geräte für Probenvorbereitung, Liquid Handling, analytische Auslesung, Lagerung und Inkubation
- Reconfigurable Automation Carts (RACs) - modulare Einheiten mit Roboterarmen, Magnetschwebe-Probentransport und Software in Industriequalität
- EstiMate - ein KI-Agent, der Protokolle in natürlicher Sprache entgegennimmt und Kompatibilitätsbewertungen zurückgibt
- Ziel sind über 100 RACs bis Ende 2026, wobei die gesamte Forschung und Entwicklung auf die autonome Plattform Nebula verlagert wird
Ginkgo demonstrierte zudem eine Zusammenarbeit mit OpenAI, bei der ein KI-System biologische Experimente autonom entwarf, ausführte und aus ihnen lernte und dabei eine Kostensenkung um 40 % bei der zellfreien Proteinsynthese erzielte (422 $/g gegenüber dem bisherigen Stand der Technik von 698 $/g).
Was das bedeutet: Ginkgo Cloud Lab kommt einem SDL der Stufe 3-4 im Produktivbetrieb am nächsten. Es ist jedoch speziell für die synthetische Biologie gebaut, äusserst kapitalintensiv und wird als Dienstleistung betrieben - Sie können die Plattform nicht kaufen und in Ihrem eigenen Labor betreiben.
Der Ansatz der Demokratisierung - RoboChem-Flex
Am anderen Ende des Spektrums zeigt RoboChem-Flex (veröffentlicht in Nature Synthesis, 2026), dass SDLs keine Infrastruktur in Millionenhöhe erfordern. Diese quelloffene, modulare Plattform kostet rund 5'000 $, läuft auf Python mit Bayes'scher Optimierung und Transfer Learning und wurde in sechs chemischen Anwendungsfällen validiert. Der gesamte Code und alle 3D-Druckdateien sind auf GitHub verfügbar.
Was das bedeutet: Das SDL-Konzept ist nicht mehr durch Hardwarekosten beschränkt. Eine Doktorandin oder ein Doktorand kann mit kleinem Budget ein System zur Optimierung im geschlossenen Regelkreis für Photokatalyse oder Kreuzkupplungsreaktionen aufbauen. Die Hürde hat sich vollständig auf Softwarefähigkeiten und Integration verlagert.
Die Softwarelücke - warum Middleware der eigentliche Engpass ist
Wenn die Hardware leistungsfähig und erschwinglich ist, warum bleiben die meisten Labore auf Stufe 2 stecken? Weil ein selbstfahrendes Labor kein automatisiertes Labor mit einem aufgesetzten KI-Modell ist. Es ist ein Softwaresystem, das zufällig physische Geräte steuert.
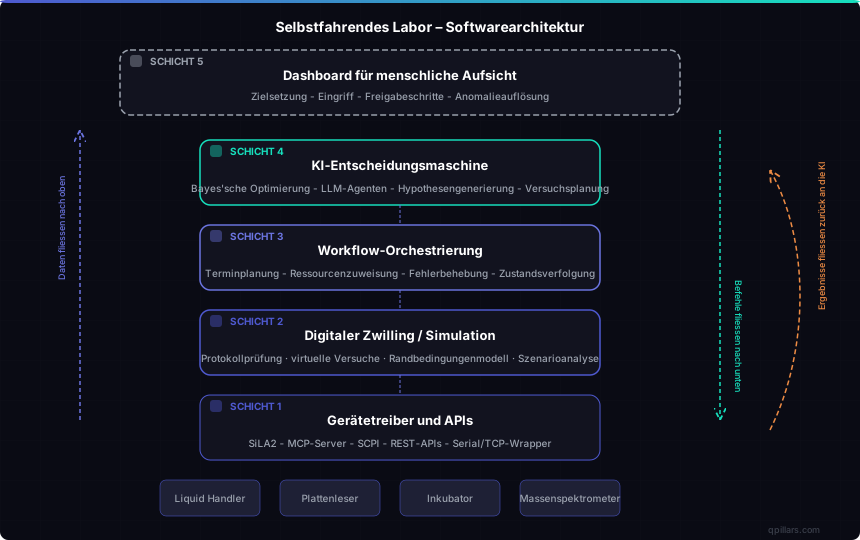
Das obige Diagramm zeigt, was ein echtes SDL auf der Softwareebene erfordert. Jede Schicht ist eine eigenständige technische Herausforderung, und die meisten «SDL»-Implementierungen adressieren nur eine oder zwei davon.
Schicht 1 - Gerätetreiber und APIs
Jedes Gerät im Labor benötigt eine programmatische Schnittstelle. Das klingt banal, ist aber das Fundament, das den meisten Laboren fehlt. Ein typisches Forschungslabor verfügt über Geräte von 5-10 Herstellern, jedes mit eigener Steuerungssoftware, eigenem Datenformat und eigenem Kommunikationsprotokoll. Manche sprechen SCPI über eine serielle Schnittstelle. Manche haben REST-APIs. Viele haben nur eine Windows-GUI ohne jeglichen programmatischen Zugriff.
Der SiLA2-Standard wurde entwickelt, um genau dieses Problem zu lösen - ein auf gRPC/Protocol Buffers basierender Kommunikationsstandard für Laborgeräte. Er ist der am besten etablierte Kommunikationsstandard im Labor und wird unter anderem von Tecan und Hamilton unterstützt. Die Verbreitung verläuft jedoch weiterhin langsam. Die meisten Geräte werden ohne SiLA2-Unterstützung ausgeliefert, und die Nachrüstung älterer Geräte erfordert die Entwicklung individueller Treiber.
MCP (Model Context Protocol) adressiert ein komplementäres Bedürfnis - Geräte für KI-Agenten zugänglich zu machen. Während SiLA2 eine strukturierte, typisierte Gerätesteuerung bietet (geeignet für deterministische Automatisierung), stellt MCP die Erkennungsfunktion und die Schnittstelle in natürlicher Sprache bereit, die KI-Agenten benötigen. Ein SiLA2-Gerät kann mit einem MCP-Server umhüllt werden, wodurch KI-Agenten Zugriff erhalten, während die SiLA2-Schnittstellen für bestehende LIMS- und Automatisierungssysteme erhalten bleiben.
Die praktische Realität: Die meisten Labore, die heute SDL-Fähigkeiten aufbauen, schreiben individuelle Python-Wrapper um die APIs der Hersteller. Das funktioniert, skaliert aber nicht. Der Wechsel zu SiLA2 + MCP wird kommen - mit einer breiten Übernahme durch die Hersteller ist jedoch erst 2027-2028 zu rechnen.
Schicht 2 - Digitaler Zwilling und Simulation
Bevor eine KI-Entscheidungsengine Befehle an physische Geräte sendet, sollten diese Befehle in der Simulation validiert werden. Ein digitaler Zwilling des Labors modelliert die Fähigkeiten der Geräte, physische Randbedingungen (Volumen, Temperaturen, Zeitabläufe) und die Protokolllogik. Er erkennt Fehler, die teure Reagenzien verschwenden oder Ausrüstung beschädigen würden.
Digitale Zwillinge ermöglichen zudem die schnelle Iteration, die SDLs wertvoll macht. Ein KI-Agent kann Tausende virtueller Experimente in Sekunden durchspielen und vielversprechende Parameterkombinationen identifizieren, bevor er sich auf eine physische Ausführung festlegt. Ohne diese Schicht beschränkt sich die «Optimierung» in einem SDL auf sequenzielle physische Experimente - um Grössenordnungen langsamer als eine simulationsgestützte Erkundung.
Die Lücke: Die meisten SDL-Implementierungen verzichten vollständig auf Simulation. Sie führen die Bayes'sche Optimierung direkt an physischen Experimenten durch, was bei einfachen Parameterscans funktioniert, bei komplexen mehrstufigen Protokollen, in denen sich Fehler aufsummieren, jedoch scheitert. Der Aufbau eines digitalen Zwillings erfordert die Modellierung des Verhaltens jedes einzelnen Geräts, womit wir wieder beim Treiber- und API-Problem sind - Sie können nicht simulieren, was Sie nicht programmatisch beschreiben können.
Schicht 3 - Workflow-Orchestrierung
In der Orchestrierung werden einzelne Geräteaktionen zu koordinierten Protokollen. Diese Schicht verwaltet die Ablaufplanung (Gerät A muss fertig sein, bevor Gerät B startet), die Ressourcenzuteilung (es darf sich jeweils nur eine Probe im Plate Reader befinden), die Fehlerbehebung (wenn die Aspiration fehlschlägt, mit angepasstem Volumen erneut versuchen) und die Zustandsverfolgung (welche Proben sich wo befinden und in welchem Schritt sie sind).
Dies ist die Schicht, die Plattformen wie Automata LINQ und die Automatisierung von Chemspeed adressieren. Hier wird auch der Unterschied zwischen «automatisiert» und «autonom» konkret. Ein automatisierter Orchestrator führt eine vordefinierte Sequenz mit bedingten Verzweigungen aus. Ein autonomer Orchestrator kann während der Ausführung auf Basis von Zwischenergebnissen neu planen - allerdings nur, wenn er Echtzeitdaten der Geräte (Schicht 1) und ein Modell dessen besitzt, was möglich ist (Schicht 2).
Schicht 4 - KI-Entscheidungsengine
Die KI-Schicht ist es, die ein selbstfahrendes Labor «selbstfahrend» macht. Sie empfängt experimentelle Ergebnisse, aktualisiert ihr Modell des Problems und entscheidet, was als Nächstes ausgeführt wird. In der Praxis reicht dies von Bayes'scher Optimierung (gut verstanden, zuverlässig für Parameterscans) bis zu LLM-basierten Agenten, die auf einer höheren Ebene über das Versuchsdesign schlussfolgern können.
Das System Coscientist der Carnegie Mellon University, das im Nature-Artikel vorgestellt wurde, demonstriert den LLM-Agenten-Ansatz: GPT-4 interpretiert wissenschaftliche Fragestellungen, sammelt Informationen aus Websuchen, plant Experimente und interagiert mit Roboterhardware. Die Zusammenarbeit von Ginkgo mit OpenAI ist ähnlich. Dies sind echte KI-Entscheidungsengines, keine aufgehübschten Optimierungsschleifen.
Die Lücke: KI-Entscheidungsengines funktionieren gut, wenn der Aktionsraum klar definiert und die Zielfunktion eindeutig ist (Ausbeute maximieren, Verunreinigungen minimieren). Schwer tun sie sich mit offener Forschung, bei der das Ziel selbst unsicher ist, Sicherheitsbeschränkungen implizit statt explizit sind und Fachwissen nötig ist, um mehrdeutige Ergebnisse zu interpretieren. Deshalb bleibt menschliche Aufsicht unverzichtbar - die KI optimiert innerhalb von Grenzen, die Menschen festlegen.
Schicht 5 - Menschliche Aufsicht
Jedes produktive SDL umfasst eine Schicht für die menschliche Aufsicht - und das ist gewollt, keine Einschränkung. In GxP-Umgebungen erfordern autonome Entscheidungen, die die Produktqualität beeinflussen, nach geltenden Vorschriften eine menschliche Freigabe. Auch in Forschungsumgebungen braucht die Wissenschaftlerin oder der Wissenschaftler Einblick darin, was das System tut und warum es bestimmte Entscheidungen getroffen hat, sowie die Möglichkeit einzugreifen, wenn etwas Unerwartetes geschieht.
Über die Aufsichtsschicht gelangt auch institutionelles Wissen in das System. Eine erfahrene Wissenschaftlerin, die eine Optimierungstrajektorie betrachtet, erkennt möglicherweise, dass das System auf ein lokales Optimum zusteuert oder dass eine bestimmte Parameterkombination zu einer Ausfällung führen wird, die der digitale Zwilling nicht modelliert. Dieses Human-in-the-Loop-Feedback unterscheidet SDLs, die nützliche Ergebnisse liefern, von SDLs, die technisch optimale, aber praktisch nutzlose Ergebnisse hervorbringen.
Die regulatorische Realität - GxP und autonome Labore
Im Januar 2026 veröffentlichten FDA und EMA gemeinsam 10 Guiding Principles of Good AI Practice in Drug Development - die erste globale regulatorische Abstimmung zu KI in pharmazeutischen und Life-Sciences-Umgebungen. Dies ist ein Meilenstein, bekräftigt aber eine grundlegende Einschränkung: Sie können Qualitätsentscheidungen nicht an einen Black-Box-Algorithmus delegieren.
Zentrale regulatorische Realitäten für SDLs in GxP-Umgebungen:
- KI-Ergebnisse sind Empfehlungen, keine Entscheidungen. Nach geltenden Vorschriften muss ein Mensch jede KI-gesteuerte Aktion freigeben, die Produktqualität, Sicherheit oder Wirksamkeit beeinflusst. Dies gilt für Chargenfreigabe, Herstellungsparameter und die Interpretation analytischer Ergebnisse.
- ALCOA+ gilt für alle Daten. Jeder Datenpunkt in einem SDL muss zuordenbar (Attributable), lesbar (Legible), zeitnah erfasst (Contemporaneous), original (Original), korrekt (Accurate), vollständig (Complete), konsistent (Consistent), dauerhaft (Enduring) und verfügbar (Available) sein. Das bedeutet, dass jeder Gerätemesswert, jede KI-Entscheidung und jede menschliche Übersteuerung in einem Audit Trail aufgezeichnet werden muss.
- 21 CFR Part 11 regelt elektronische Aufzeichnungen. Die digitale Infrastruktur eines SDL - Gerätedaten, KI-Entscheidungen, Orchestrierungsprotokolle - fällt unter die Vorschriften für elektronische Aufzeichnungen. Audit Trails, Zugriffskontrollen und elektronische Signaturen sind obligatorisch.
- Die CSA-Leitlinie der FDA (2025) hilft. Der Wechsel von erschöpfender Dokumentation zu risikobasiertem kritischem Denken macht eine konforme Einführung von KI praktikabler. Sie müssen nicht jede mögliche KI-Ausgabe validieren - Sie müssen nachweisen, dass das System für seinen bestimmungsgemässen Gebrauch zuverlässig ist und die Risiken beherrscht werden.
Praktische Konsequenz: SDLs in regulierten Umgebungen werden auf absehbare Zeit auf Stufe 3-4 arbeiten, mit menschlichen Freigabepunkten an kritischen Entscheidungsstellen. Ein vollständig autonomer Betrieb (Stufe 5) ist regulatorisch nicht unmöglich - es ist eine technische Herausforderung, eine so hohe Zuverlässigkeit nachzuweisen, dass die Behörden bereit sind, auf die menschliche Aufsicht zu verzichten. Dieser Nachweis existiert noch nicht.
Warum MCP für selbstfahrende Labore wichtig ist
Das Model Context Protocol ist nicht einfach ein weiterer Integrationsstandard. Es löst ein spezifisches Problem, das die SDL-Entwicklung blockiert: KI-Agenten zu ermöglichen, Laborgeräte über eine einheitliche Schnittstelle zu erkennen, zu verstehen und zu nutzen.
Die herkömmliche Geräteintegration erfolgt Punkt-zu-Punkt. Sie schreiben einen Python-Wrapper für den Plate Reader, einen weiteren für den Liquid Handler, einen weiteren für den Inkubator. Jeder Wrapper hat seine eigene API, seine eigene Fehlerbehandlung, sein eigenes Datenformat. Ein KI-Agent, der alle drei orchestriert, benötigt für jeden individuellen Code. Ein neues Gerät hinzuzufügen bedeutet, den Agenten anzupassen.
MCP kehrt dieses Modell um. Jedes Gerät stellt einen MCP-Server bereit, der seine Fähigkeiten in einem Standardformat beschreibt. Ein KI-Agent erkennt verfügbare Geräte über MCP, versteht anhand standardisierter Werkzeugbeschreibungen, was sie können, und nutzt sie über eine einheitliche Schnittstelle. Ein neues Gerät hinzuzufügen bedeutet, einen einzigen MCP-Server bereitzustellen - jeder Agent im Labor erhält sofort Zugriff.
Im Dezember 2025 übergab Anthropic MCP an die Agentic AI Foundation unter dem Dach der Linux Foundation, die von Anthropic, Block und OpenAI mitbegründet wurde und zu deren Platin-Unterstützern Google, Microsoft und AWS gehören. Die MCP Registry umfasst über 1'000 Servereinträge, Tendenz steigend. Die Spezifikation vom November 2025 ergänzte Funktionen für Unternehmen: Authentifizierung mit OAuth 2.1, Verifizierung der Serveridentität und Streaming für Gerätedaten in Echtzeit.
MCP und SiLA2 sind komplementär, nicht konkurrierend:
| Aspekt | SiLA2 | MCP |
|---|---|---|
| Zweck | Strukturierte Gerätesteuerung | Werkzeugzugriff für KI-Agenten |
| Transport | gRPC / Protocol Buffers | JSON-RPC über stdio/HTTP |
| Typisierung | Stark typisiert (FDL) | Schemabasierte Werkzeugbeschreibungen |
| Am besten geeignet für | Deterministische Automatisierung, LIMS-Integration | KI-gestützte Erkennung, Interaktion in natürlicher Sprache |
| Reifegrad | Etabliert, langsame Verbreitung | Früh, schnelles Wachstum |
Die optimale Architektur nutzt beide: SiLA2 für die deterministische Steuerungsschicht (Schicht 1), MCP für die Schnittstelle zu KI-Agenten (Schicht 4). Ein Gerät mit SiLA2-Schnittstelle erhält einen MCP-Server-Wrapper, der seine SiLA2-Fähigkeiten für KI-Agenten bereitstellt. Bestehende LIMS- und Automatisierungssysteme nutzen SiLA2 weiterhin direkt. Neue KI-Workflows nutzen MCP. Eine Migration ist nicht erforderlich.
Warnende Beispiele
Nicht jede SDL-Geschichte ist eine Erfolgsgeschichte. Zwei Beispiele verdeutlichen die Risiken:
Strateos betrieb in Menlo Park ein vollautomatisiertes Cloud-Labor - einer der frühesten Versuche von «Lab-as-a-Service». Das Unternehmen wandte sich vom öffentlichen Cloud-Lab-Modell ab und hin zu privaten On-Premises-Implementierungen - ein Signal dafür, dass das reine Fernzugriffsmodell, bei dem Kunden Experimente an eine gemeinsam genutzte Roboterinfrastruktur übermitteln, im grossen Massstab auf kommerzielle Herausforderungen stiess. Die Lehre daraus: SDL-Infrastruktur ist wertvoll, aber das Geschäftsmodell ist entscheidend. Labore wollen die Kontrolle über ihre physische Infrastruktur, keinen Black-Box-Dienst.
IBM RoboRXN (IBM Research Zürich) hat eine beeindruckende, über die Cloud zugängliche autonome Chemieplattform mit über 29'000 Nutzenden und 5 Millionen Reaktionsvorhersagen aufgebaut. Sie demonstrierte die Schicht der KI-Entscheidungsengine überzeugend. Die Übertragung von Forschungsdemonstrationen in eine produktive Laborinfrastruktur bleibt jedoch eine Lücke - die Plattform glänzt bei der Vorhersage und Planung von Reaktionen, doch die physische Ausführung hängt von Partnerschaften mit Automatisierungsanbietern ab (Chemspeed, Arctoris).
Wohin die Entwicklung 2026-2027 geht
Die SDL-Landschaft wird sich entlang dreier Trends konsolidieren:
1. Standardisierung - MCP + SiLA2 als Kommunikationsschicht
Die Fragmentierung der Kommunikationsprotokolle für Geräte ist das grösste einzelne Hindernis für die Einführung von SDLs. Jeder individuelle Wrapper ist technische Schuld. Das Zusammenwachsen von MCP (für den KI-Zugriff) und SiLA2 (für die strukturierte Steuerung) bietet einen gangbaren Weg zur Standardisierung. Es ist zu erwarten, dass Gerätehersteller bis Ende 2027 beginnen werden, MCP-Server zusammen mit ihrer proprietären Software auszuliefern - nicht speziell aufgrund der SDL-Nachfrage, sondern getrieben von der breiteren Welle der Einführung von KI-Agenten in allen Branchen.
2. Konsolidierung - Plattformen setzen sich durch
Die aktuelle SDL-Landschaft umfasst Dutzende von Einzellösungen - hier ein Bayes'scher Optimierer, dort ein Gerätetreiber, anderswo eine Scheduling-Engine. Labore, die diese zusammenfügen, verbringen mehr Zeit mit Integration als mit Wissenschaft. Die Plattformen, die mehrere SDL-Schichten integrieren (Chemspeed/SciY, Automata LINQ, Ginkgo Cloud Lab), werden den Einzellösungen Marktanteile abnehmen. Gewinnen werden Plattformen, die offen (herstellerunabhängige Geräteunterstützung), geschichtet (schrittweise einführbar) und KI-nativ (nicht mit nachträglich aufgesetzter KI) sind.
3. Die Softwareschicht als Wettbewerbsvorteil
Die Kommodifizierung der Hardware beschleunigt sich. Die Plattform RoboChem-Flex beweist, dass leistungsfähige Automatisierungshardware für 5'000 $ gebaut werden kann. Nicht die Geräte selbst sind das Unterscheidungsmerkmal, sondern die Software, die sie verbindet, orchestriert und über sie schlussfolgert. Labore, die in die Softwareschicht investieren - Geräte-APIs, Datenpipelines, digitale Zwillinge, MCP-Infrastruktur -, werden gut positioniert sein, um SDL-Fähigkeiten zu übernehmen, sobald die Plattformen ausreifen. Labore, die auf schlüsselfertige Lösungen warten, werden an denjenigen Hersteller gebunden sein, der zuerst ans Ziel kommt.
Das Ziel des Acceleration Consortium - die Entdeckung neuer Materialien von 10 Mio. $ und 10 Jahren auf 1 Mio. $ und 1 Jahr zu reduzieren - ist ambitioniert, aber in der Richtung richtig. Die Labore, die als Erste dort ankommen, werden nicht diejenigen mit den meisten Robotern sein. Es werden diejenigen mit der besten Software sein.
Häufig gestellte Fragen
Was ist ein selbstfahrendes Labor?
Ein selbstfahrendes Labor (SDL) ist eine Forschungseinrichtung, in der KI-Systeme Experimente autonom entwerfen, Roboterplattformen sie ausführen und die KI die Ergebnisse analysiert, um zu entscheiden, was als Nächstes ausgeführt wird - wodurch ein geschlossener Design-Build-Test-Learn-Zyklus entsteht. In der Praxis arbeiten die meisten SDLs heute auf Stufe 2-3 einer fünfstufigen Autonomieskala, das heisst, sie übernehmen die Optimierung im geschlossenen Regelkreis für spezifische Aufgaben, während Menschen die Ziele vorgeben und Ausnahmen behandeln. Echte Autonomie der Stufe 5 - bei der das Labor ganz ohne menschliches Eingreifen arbeitet - existiert noch nicht.
Wie viel kostet der Aufbau eines selbstfahrenden Labors?
Die Bandbreite ist enorm. Quelloffene Plattformen wie RoboChem-Flex lassen sich für rund 5'000 $ bauen und bewältigen die Optimierung im geschlossenen Regelkreis für spezifische chemische Anwendungen. SDL-Implementierungen für Unternehmen von Chemspeed oder über den Cloud-Lab-Dienst von Ginkgo kosten Millionen. Die Infrastruktur des Acceleration Consortium beruht auf einem Zuschuss von 200 Mio. Can$. Für die meisten Labore ist ein schrittweiser Weg praktikabel: Beginnen Sie damit, bestehende Geräte mit programmatischen APIs auszustatten (10'000-50'000 $ pro Gerät), bauen Sie Datenpipelines und einen digitalen Zwilling auf (100'000-500'000 $ Entwicklungsaufwand) und ergänzen Sie KI-Entscheidungsfähigkeiten, sobald die Infrastruktur ausgereift ist.
Können selbstfahrende Labore in GxP-regulierten Umgebungen betrieben werden?
Ja, allerdings mit Einschränkungen. Die gemeinsamen Guiding Principles of Good AI Practice in Drug Development von FDA und EMA (Januar 2026) bieten einen Rahmen für KI in regulierten Umgebungen. KI-Ergebnisse müssen als Empfehlungen behandelt werden, die bei qualitätskritischen Entscheidungen eine menschliche Freigabe erfordern. Alle Daten müssen den ALCOA+-Grundsätzen entsprechen, und elektronische Aufzeichnungen fallen unter 21 CFR Part 11. Die Computer-Software-Assurance-Leitlinie der FDA von 2025 macht die Einhaltung praktikabler, indem sie von erschöpfender Dokumentation zu risikobasierten Ansätzen übergeht. SDLs in GxP-Umgebungen werden voraussichtlich auf Stufe 3-4 arbeiten, mit menschlichen Freigabepunkten an kritischen Entscheidungsstellen.
Was ist der Unterschied zwischen MCP und SiLA2 für Laborgeräte?
SiLA2 ist ein strukturierter Kommunikationsstandard für Laborgeräte auf Basis von gRPC und Protocol Buffers - er definiert, wie Software Geräte mit strikter Typisierung und deterministischem Verhalten steuert. MCP (Model Context Protocol) ist ein Standard zur Anbindung von KI-Agenten an externe Werkzeuge - er definiert, wie ein KI-System Geräte über Schnittstellen, die sich für natürliche Sprache eignen, erkennt und nutzt. Beide sind komplementär: SiLA2 übernimmt die deterministische Steuerungsschicht, MCP den Zugriff durch KI-Agenten. Ein Gerät kann beide Schnittstellen gleichzeitig bereitstellen, wobei bestehende Automatisierung SiLA2 und neue KI-Workflows MCP nutzen.
Welche Branchen führen selbstfahrende Labore am schnellsten ein?
Materialwissenschaft und Chemie sind führend, insbesondere bei der Reaktionsoptimierung und dem Materialscreening. Die Wirkstoffforschung folgt dicht dahinter, wobei Unternehmen wie Arctoris (Oxford) und Recursion automatisierte Plattformen für das Screening von Verbindungen betreiben. Die synthetische Biologie ist am ambitioniertesten - Ginkgo Bioworks hat sich verpflichtet, bis Ende 2026 die gesamte Forschung und Entwicklung auf autonome Infrastruktur zu verlagern. Umweltanalytik und klinische Diagnostik sind aufgrund strengerer regulatorischer Anforderungen langsamer, doch die sich weiterentwickelnden KI-Leitlinien der FDA ebnen den Weg schrittweise.
Ist der Hype um selbstfahrende Labore gerechtfertigt?
Teilweise. Die zugrunde liegende Technologie funktioniert - Optimierung im geschlossenen Regelkreis, robotische Ausführung und KI-gestütztes Versuchsdesign bringen auf Stufe 2-3 echte Produktivitätsgewinne. Der Markt für Laborautomatisierung, der von 8,9 Mrd. $ auf 24 Mrd. $ bis 2035 wächst, spiegelt eine echte Nachfrage wider. Überzogen sind der Zeitrahmen und der Umfang: Marketingmaterialien suggerieren eine Autonomie der Stufe 4-5, die es nicht gibt, und die meisten «SDL»-Ankündigungen beschreiben Plattformen, die eine oder zwei Schichten des erforderlichen Software-Stacks abdecken. Die Lücke ist real, schliesst sich aber. Labore, die jetzt die Softwareinfrastruktur aufbauen, werden bereit sein, wenn die Plattformen aufholen.
Verfasst von Iacob Marian, Technischer Leiter und Mitgründer bei QPillars. Veröffentlicht am 2026-04-16.
Technischer Leiter und Mitgründer bei QPillars
Spezialisiert auf Laborautomatisierung – von der praktischen Gerätesteuerung und Flüssigkeitshandhabung bis zur KI-gestützten Orchestrierung von Protokollen.