
Wie Sie KI-Agenten in einem GMP-Labor einsetzen, ohne das LLM in den kritischen Pfad zu stellen
Wie Sie KI-Agenten in einem GMP-Labor einsetzen, ohne das LLM in den kritischen Pfad zu stellen
Sie können KI-Agenten schon heute in einem GMP-regulierten Labor einsetzen, aber nur, wenn das Modell nicht auf das Produkt einwirkt. Der Entwurf des EU-GMP-Annex 22 erfasst für kritische Anwendungen nur statische, eingefrorene, deterministische Modelle. Zudem hält er fest, dass generative KI und Large Language Models «nicht in kritischen GMP-Anwendungen eingesetzt werden sollten». Der Einwand richtet sich gegen Modelle, die bei identischen Eingaben unterschiedliche Ausgaben erzeugen. Der Weg führt über die Architektur, nicht über die Regulierung: Setzen Sie das LLM dort ein, wo es vorschlägt, aber nie entscheidet. Die Schicht, die das Gerät tatsächlich bewegt, muss deterministisch, qualifizierbar und unspektakulär sein.
In diesem Beitrag geht es um Softwarearchitektur, nicht um regulatorische Beratung. Wir sind Ingenieure für Gerätesoftware, keine Regulatory-Beratung. Wir zitieren, was in den Entwürfen steht, und legen es nicht für Ihre Einreichung aus. Wir können Ihnen aber zeigen, wie Sie ein System bauen, bei dem sich diese Frage gar nicht erst stellt.
Das Wichtigste in Kürze
- Der Einwand der Regulierungsbehörde richtet sich gegen Nichtdeterminismus, nicht gegen KI. Annex 22 lässt statische Modelle zu, «bei denen alle Parameter endgültig festgelegt wurden» und die «ihre Leistung während der Nutzung nicht anpassen». Ein LLM erfüllt diese Anforderung schon konstruktionsbedingt nicht.
- Der Entwurf erfasst generative KI überhaupt nicht. Er hält fest, dass «das Dokument nicht für generative KI und Large Language Models (LLM) gilt», und sagt, dass diese nicht in kritischen GMP-Anwendungen eingesetzt werden sollten. Für nicht kritische Anwendungen gilt: «Qualifiziertes und geschultes Personal sollte dafür verantwortlich sein, dass die Ausgaben für den vorgesehenen Verwendungszweck geeignet sind.»
- Das wird bereits durchgesetzt. Im April 2026 versandte die FDA ihren ersten KI-bezogenen Warning Letter. Sie stützte sich auf 21 CFR 211.22(c), nachdem KI-Agenten CGMP-Spezifikationen, -Verfahren und -Aufzeichnungen ohne Prüfung durch die Qualitätseinheit (Quality Unit) erstellt hatten.
- Die Antwort der Architektur: Die Ausgabe des Agenten ist ein Dokument, keine Aktion. Zwischen dem Vorschlag und dem Gerät stehen ein deterministischer Validator und ein deterministischer Executor. Diese beiden Komponenten qualifizieren Sie.
- Das ist kein Workaround, sondern bessere Ingenieursarbeit. Dieselbe Trennung bringt Ihnen reproduzierbare Ausführung, einen echten Audit Trail und die Möglichkeit zum Probelauf. Das wollen Sie unabhängig davon, ob Sie reguliert sind.
- Der Zeitplan steht. Die Konsultation endete am 7. Oktober 2025. Stand August 2026 gibt es keinen finalen Text, und die EMA will der Europäischen Kommission den finalen Text im Q4 2026 vorlegen.
Was der Entwurf von Annex 22 tatsächlich sagt
Annex 22 ist ein ergänzender Anhang zum EU-GMP-Leitfaden. Er wurde zusammen mit einem PIC/S-Pendant zur Konsultation veröffentlicht. Die Konsultation endete am 7. Oktober 2025. Stand August 2026 wurde noch kein finaler Text verabschiedet. Die EMA will der Europäischen Kommission im Q4 2026 einen vorlegen.
Der Geltungsbereich ist eng und bewusst so gewählt. Er umfasst KI in kritischen GMP-Anwendungen, also in Anwendungen mit direkter Auswirkung auf Patientensicherheit, Produktqualität oder Datenintegrität. Innerhalb davon gilt er für statische und deterministische Modelle: Alle Parameter sind endgültig festgelegt, und während der Nutzung findet keine Anpassung statt.
Was ausgeschlossen ist, wiegt schwerer als das, was eingeschlossen ist:
- Dynamische Modelle, die «während der Nutzung kontinuierlich und automatisch lernen und ihre Leistung anpassen», sollten nicht in kritischen GMP-Anwendungen eingesetzt werden.
- Modelle mit probabilistischer Ausgabe, also Modelle, die bei identischen Eingaben unterschiedliche Ausgaben liefern können.
- Generative KI und LLMs: Laut Entwurf gilt das Dokument nicht für sie, und sie sollten nicht in kritischen Anwendungen eingesetzt werden.
In nicht kritischen Anwendungen sind generative KI und LLMs nicht verboten. Erwartet wird, dass «qualifiziertes und geschultes Personal dafür verantwortlich sein sollte, dass die Ausgaben für den vorgesehenen Verwendungszweck geeignet sind». Es braucht also einen dokumentierten Punkt, an dem ein Mensch prüft und eingreifen kann.
Der übrige Entwurf ist klassisches GMP: Modelle stehen vor dem Einsatz unter Change Control; die Erklärbarkeit wird über Feature-Attribution (SHAP, LIME) sichergestellt und bei der Freigabe der Testergebnisse geprüft; wo anwendbar, werden Konfidenzwerte protokolliert, wobei Ergebnisse mit niedriger Konfidenz als «unentschieden» gelten und nicht geraten werden; mit definierten Metriken wird überwacht, ob die Eingabedaten vom ursprünglichen Trainingsbereich abdriften; und nach dem Vier-Augen-Prinzip zertifiziert nicht dieselbe Person die Testergebnisse, die die Trainingsdaten kuratiert.
Es gibt auch Bewegung. Ein EMA-Workshop im Juni und Juli 2026 zeigte, dass die Stakeholder generative KI im Rahmen eines risikobasierten Ansatzes nach den Grundsätzen von ICH Q9(R1) zulassen möchten. Die Entwicklung geht also dahin, unter Bedingungen mehr zu erlauben. So weit ist es aber noch nicht.
Fazit: Die Regulierungsbehörde wendet sich nicht gegen künstliche Intelligenz. Sie wendet sich gegen eine Komponente, deren Verhalten Sie nicht festlegen können und die an einer Stelle sitzt, die das Produkt beeinflusst.
Der erste KI-Warning-Letter der FDA hat es konkret gemacht
Im April 2026 versandte die FDA an Purolea Cosmetic Lab einen Warning Letter, der weithin als erster Warning Letter gilt, der KI-Missbrauch als GMP-Verstoss anführt. KI-Agenten hatten Arzneimittelspezifikationen, Verfahren sowie Master Production and Control Records erstellt. Diese Dokumente wurden ohne menschliche Prüfung verwendet.
Die FDA erliess keine neue KI-Regel. Sie wandte 21 CFR 211.22(c) an, also die bestehende Anforderung, dass die Qualitätseinheit solche Aufzeichnungen prüft und freigibt. Zudem hielt sie fest: Wird KI zur Unterstützung von CGMP-Tätigkeiten eingesetzt, müssen alle Ergebnisse oder Empfehlungen eines KI-Agenten von einer autorisierten Vertretung der Qualitätseinheit geprüft und freigegeben werden. (Analyse von Pharmaceutical Technology)
Zwei Punkte verdienen Beachtung. Die Massnahme betraf weder ein autonomes Labor noch einen Roboterarm. Sie betraf KI-Ausgaben, die ohne einen Menschen dazwischen in eine kontrollierte Aufzeichnung gelangten. Und die Abhilfe ist ein Kontrollpunkt, kein Verbot.
Damit liefert eine Durchsetzungsmassnahme den gesamten Designauftrag: Es muss einen definierten Punkt geben, an dem die Ausgabe des Modells ein Vorschlag ist, und einen definierten Akt, durch den sie freigegeben wird.
Fazit: Die Regulierungsbehörden fragen nicht, ob Sie ein Modell verwendet haben. Sie fragen, was zwischen dem Modell und der Aufzeichnung stand.
Die Architektur: Der Agent schlägt vor, eine deterministische Schicht entscheidet
Daraus ergibt sich die folgende Struktur. Sie ist kein Compliance-Trick, sondern die Architektur, die Sie ohnehin wollen würden. Über jeden Baustein haben wir bereits einzeln geschrieben, ohne je den regulatorischen Grund zu nennen, warum er wichtig ist.
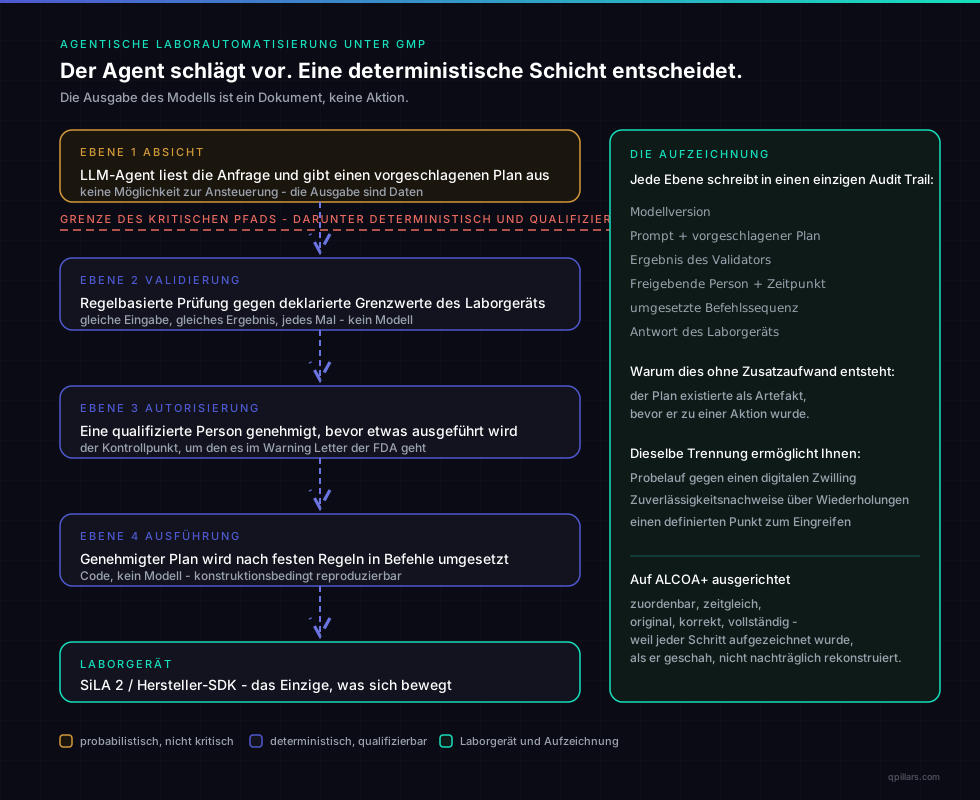
Das Diagramm zeigt vier Schichten und eine Grenze. Oberhalb der Linie interpretiert der Agent eine Anfrage und gibt einen vorgeschlagenen Plan aus. Noch hat sich nichts bewegt, denn die Ausgabe ist ein Dokument. Unterhalb der Linie ist alles deterministisch und qualifizierbar. Ein Validator prüft den Vorschlag gegen die deklarierten Grenzwerte des Geräts. Bei kritischen Anwendungen gibt ein Mensch ihn frei. Danach übersetzt ein Executor den freigegebenen Plan nach festen Regeln in Gerätebefehle. Jeder Schritt wird in einen Audit Trail geschrieben.
Schicht 1: Absicht, probabilistisch, ausserhalb des kritischen Pfads. Das LLM liest, was die Wissenschaftlerin oder der Wissenschaftler angefragt hat, und schlägt einen strukturierten Plan vor. Es kann nichts ansteuern. Seine Ausgabe sind Daten.
Schicht 2: Validierung, deterministisch. Ein regelbasierter Validator prüft den vorgeschlagenen Plan gegen die deklarierten Fähigkeiten und physikalischen Grenzen des Geräts. Dazu gehören Volumina, Kapazitäten, Tip-Zustand, Erreichbarkeit und Labware-Kompatibilität. Gleiche Eingabe, gleiches Urteil, jedes Mal. Diese Komponente qualifizieren Sie, und sie ist gewöhnliche Software: kein Modell, kein Sampling, keine Temperature.
Schicht 3: Freigabe. Bei kritischen Anwendungen wird der validierte Plan vor der Ausführung zur Freigabe vorgelegt. Um diesen Kontrollpunkt geht es im Purolea-Letter. Hier wird auch die Erwartung erfüllt, dass «qualifiziertes und geschultes Personal für die Ausgabe verantwortlich» ist.
Schicht 4: Ausführung, deterministisch. Tools auf Absichtsebene übersetzen den freigegebenen Plan in die eigenen Befehle des Geräts. Diese Übersetzung ist Code. Derselbe freigegebene Plan erzeugt jedes Mal dieselbe Befehlsfolge, und genau diese Eigenschaft verlangt der Annex.
Unter allen vier Schichten liegt die Aufzeichnung: Modellversion, Prompt, vorgeschlagener Plan, Urteil des Validators, Identität der freigebenden Person und Antwort des Geräts. Das ergibt einen Audit Trail nach ALCOA+. Sie erhalten ihn, weil der Plan ein Artefakt war, bevor er zur Aktion wurde.
Fazit: Das LLM wird nicht konform gemacht. Es wird für den Teil bedeutungslos gemacht, der konform sein muss.
Warum das ohnehin die bessere Ingenieursarbeit ist
Die unbequeme Frage lautet, ob das nicht regulatorisches Theater ist, das alles verlangsamt. Das ist es nicht. Wir würden es auch in einem nicht regulierten Labor so bauen.
Sie können Probeläufe durchführen. Der Plan liegt vor der Ausführung als Daten vor. Deshalb können Sie ihn zuerst gegen einen digitalen Zwilling laufen lassen und sehen, was er bewirken würde. Der Zustand des Zwillings ist die massgebliche Referenz, er lässt sich deterministisch zurücksetzen, und ein Plan, der dort an der Validierung scheitert, kostet nichts. Das ist zugleich ein Werkzeug für die Qualifizierung und für die Produktivität.
Sie können Belege statt Meinungen liefern. Lassen Sie ein Korpus von Szenarien wiederholt gegen die deterministischen Schichten laufen, erhalten Sie Zuverlässigkeitszahlen statt Zusicherungen. Massgeblich ist nicht, ob es einmal funktioniert hat, sondern ob es bei jeder Wiederholung funktioniert hat. In publizierten Agenten-Benchmarks fällt dieser Unterschied drastisch aus: τ-bench berichtet, dass Function-Calling-Agenten auf dem Stand der Technik weniger als 50 % der Aufgaben lösen, mit pass^8 unter 25 % in der Retail-Domäne.
Sie begrenzen den Fehler, der tatsächlich auftritt. Der häufigste Agentenfehler in der aktuellen Forschung bleibt unbemerkt: Ein Agent meldet selbstsicher, eine Aufgabe sei erledigt, obwohl er sie nicht erledigt hat. Darauf entfallen 45–48 % der Fehler in den Single-Control-Domänen von τ²-bench und 75,8 % der selbstbewertenden Coding-Agent-Trajektorien in AppWorld. Einen deterministischen Validator zwischen Vorschlag und Ansteuerung kümmert es nicht, wie selbstsicher das Modell seine Zusammenfassung formuliert hat.
Und genau hier steckt die Branche ohnehin fest. Laut der CIO-Umfrage 2026 von Gartner liegt die Verbreitung produktiv eingesetzter Agenten bei 17 %. Rund 60 % der Führungskräfte nennen die Integration von Altsystemen als ihre grösste KI-Herausforderung, und 35 % bezeichnen sie als das grösste einzelne Hindernis für die Skalierung. Als Grund wird angegeben, dass bestehende Systeme für menschliche Bediener und nicht für autonome Agenten konzipiert wurden. Die hier beschriebene Schicht ist genau dieses fehlende Stück. Sie müssen sie bauen, ob eine Regulierungsbehörde das verlangt oder nicht.
Fazit: Dieselbe Trennung, die den Annex erfüllt, sorgt überhaupt erst dafür, dass agentische Laborautomatisierung funktioniert.
Wo ein LLM weiterhin echten Nutzen bringt
Nichts davon spricht für weniger KI. Es spricht dafür, KI dort einzusetzen, wo ihre Stärken keine Risiken sind:
- Die Anfrage interpretieren. Aus «Lege eine Verdünnungsreihe über die Platte mit diesen Konzentrationen an» einen strukturierten, prüfbaren Plan zu machen, ist genau das, was ein Sprachmodell gut kann. Ein Fehler kostet nichts, weil als Nächstes der Validator kommt.
- Dokumente lesen. SOPs, Methodendateien, Bedingungstabellen. Das ist Sprachverarbeitung und bleibt unkritisch, bis etwas darauf basierend handelt.
- Einen Fehler erklären. Scheitert ein Lauf, ist eine Zusammenfassung des Geschehens aus dem Audit Trail sehr wertvoll und berührt nichts.
- Entwürfe zur Freigabe durch einen Menschen erstellen. Das ist zulässig, und der Purolea-Letter sagt Ihnen genau, wie Sie damit umgehen: Eine namentlich benannte Person prüft und gibt frei, bevor der Entwurf in eine kontrollierte Aufzeichnung gelangt.
Ein LLM sollte aber nicht über ein Volumen entscheiden und es ohne Kontrolle dazwischen an eine Pipette senden.
Was Sie tun sollten, wenn Sie jetzt kaufen oder entwickeln
- Zeichnen Sie Ihren kritischen Pfad. Halten Sie jede Komponente zwischen einer Benutzeranfrage und einer physischen Aktion oder einer kontrollierten Aufzeichnung fest. Alles auf diesem Pfad muss deterministisch und qualifizierbar sein. Die meisten Teams haben diesen Pfad nie gezeichnet und sind überrascht, was darauf liegt.
- Prüfen Sie, ob der Agent Ihres Anbieters vorschlagen kann, ohne auszuführen. Ruft das Modell das Gerät direkt auf, gibt es keine Grenze. Dann können Sie keinen Kontrollpunkt dort setzen, wo die FDA soeben einen verlangt hat.
- Fragen Sie, was die Validierungsschicht tatsächlich validiert. «Das Modell ist mit Labordaten trainiert» ist keine Antwort. Grenzwerte, die vor der Ansteuerung durchgesetzt werden, sind eine Antwort.
- Verlangen Sie Belege für die Zuverlässigkeit, keine Demo. Gemeint ist die Erfolgsquote über wiederholte Läufe mit Ihren Workflows, nicht ein aufgezeichneter Idealablauf.
- Beginnen Sie mit nicht kritischen Anwendungen. Dokumentinterpretation, Zusammenfassung von Läufen, Methodenentwürfe mit menschlicher Freigabe. Das bringt echten Nutzen ohne Risiko im kritischen Pfad und baut den Audit Trail auf, den Sie später brauchen werden.
- Warten Sie mit Ihrer Architektur nicht auf den finalen Text. Die Trennung mit deterministischer Ausführung verlangt gute Ingenieursarbeit ohnehin. Sie nachträglich einzubauen, wenn Sie bereits auf direkten Aufrufen vom Modell an das Gerät aufgebaut haben, ist teuer.
Häufig gestellte Fragen
Kann man KI-Agenten in einem GMP-regulierten Labor einsetzen?
Ja, sofern das Modell nicht im kritischen Pfad liegt. Der Entwurf von Annex 22 erfasst für kritische GMP-Anwendungen nur statische deterministische Modelle. Er hält fest, dass generative KI und LLMs dort nicht eingesetzt werden sollten. In nicht kritischen Anwendungen sind sie erlaubt, wenn qualifiziertes Personal für die Ausgaben verantwortlich ist. In einer Architektur, in der der Agent einen Plan vorschlägt und eine deterministische Schicht ihn validiert und ausführt, bleibt das Modell auf der zulässigen Seite dieser Linie.
Was sagt der Entwurf von Annex 22 über LLMs?
Er sagt, dass das Dokument nicht für generative KI und Large Language Models gilt und dass diese nicht in kritischen GMP-Anwendungen eingesetzt werden sollten. Der eigentliche Einwand ist Nichtdeterminismus. Er betrifft Modelle, die bei identischen Eingaben unterschiedliche Ausgaben liefern können, sowie Modelle, die während der Nutzung kontinuierlich lernen und sich anpassen. Für nicht kritische Anwendungen wird erwartet, dass qualifiziertes, geschultes Personal dafür verantwortlich ist, dass die Ausgaben für ihren vorgesehenen Verwendungszweck geeignet sind.
Ist Annex 22 in Kraft?
Stand August 2026 nicht. Die Konsultation endete am 7. Oktober 2025, und es wurde noch kein finaler Text verabschiedet. Die EMA will der Europäischen Kommission den finalen Text im Q4 2026 vorlegen. Ein EMA-Workshop Mitte 2026 deutete eine mögliche risikobasierte Öffnung für generative KI an. Betrachten Sie den Annex als Entwicklungsrichtung und nicht als geltendes Recht. Beachten Sie aber, dass die FDA dasselbe Verantwortlichkeitsprinzip bereits unter den bestehenden CGMP-Regeln durchgesetzt hat.
Was hat der erste KI-Warning-Letter der FDA tatsächlich verlangt?
Er verlangte, dass alle Ergebnisse oder Empfehlungen eines KI-Agenten vor der Verwendung von einer autorisierten Vertretung der Qualitätseinheit geprüft und freigegeben werden, wenn KI CGMP-Tätigkeiten unterstützt. Die FDA wandte dabei die bestehende Vorschrift 21 CFR 211.22(c) an und keine KI-spezifische Regelung. Anlass war, dass KI-generierte Spezifikationen, Verfahren und Produktionsaufzeichnungen ohne menschliche Prüfung verwendet worden waren.
Wird das System weniger leistungsfähig, wenn das LLM ausserhalb des kritischen Pfads bleibt?
Nein, es ändert sich nur, wo die Intelligenz sitzt. Das Modell interpretiert weiterhin die Anfrage, liest die Dokumente und erklärt Fehler. Das ist die Arbeit, die Sprachmodelle wirklich gut können. Es entscheidet aber nicht mehr über einen physikalischen Parameter und steuert ihn nicht mehr ungeprüft an. Genau diesen Fehlermodus bezeichnet die Forschungsliteratur als den häufigsten und gefährlichsten.
Wir bauen die deterministische Schicht. Unsere Werkzeuge für SiLA 2 und MCP sind Open Source. Die hier beschriebene Trennung zwischen Validierung und Ausführung liegt auch unserer eigenen Gerätesoftware zugrunde. Dazu gehören der digitale Zwilling für Probeläufe und das Evaluations-Harness, das die Belege für die Zuverlässigkeit liefert. Nennen Sie uns ein Gerät und einen Workflow, und wir zeichnen gemeinsam mit Ihnen Ihren kritischen Pfad und sagen Ihnen, was darauf liegt. Kontaktieren Sie uns.
Dieser Artikel beschreibt Softwarearchitektur. Er ist keine regulatorische Beratung, und QPillars ist keine Regulatory-Beratung. Lassen Sie jede Compliance-Auslegung von Ihrer eigenen Qualitätsfunktion prüfen.
Verfasst von Iacob Marian, Technischer Leiter und Mitgründer von QPillars. Dort baut er die Infrastruktur, mit der KI-Agenten Laborgeräte sicher und zuverlässig bedienen können. Veröffentlicht am 2026-08-10.
Technischer Leiter und Mitgründer bei QPillars
Spezialisiert auf Laborautomatisierung – von der praktischen Gerätesteuerung und Flüssigkeitshandhabung bis zur KI-gestützten Orchestrierung von Protokollen.