
Kann ein KI-Assistent Fehler an Laborgeräten eingrenzen? Eine Architektur mit lokalen LLMs
Ein Laborgerät stoppt mitten in einem Lauf. Die Bedienperson sieht eine kurze Fehlermeldung. Die Erklärung ist möglicherweise auf ein Betriebshandbuch, einen Software-Versionshinweis und eine Protokolldatei verteilt. Bevor jemand über das weitere Vorgehen entscheiden kann, müssen diese Fakten zusammengeführt werden.
Das ist eine nützliche Aufgabe für einen KI-Assistenten für Laborgeräte: das gemeldete Problem erklären, relevante Nachweise sammeln und einer Person helfen, den nächsten Prüfschritt zu wählen. Ein kleines lokales Sprachmodell kann dafür infrage kommen, wenn die Aufgabe klar definiert und das Wissen auffindbar ist. Die Architektur muss dieses Wissen bereitstellen und die Schlussfolgerungen des Modells auf das beschränken, was daraus hervorgeht.
Mit einem gestoppten Lauf und einem klaren Auftrag beginnen
«Warum hat dieser Lauf gestoppt, was sollte ich als Nächstes prüfen und was sollte ich dem Support schicken?»
Für die Bedienperson ist das nützliche Ergebnis eine Erklärung zu diesem Lauf, ein passender nächster Prüfschritt und bei Bedarf eine klare Übergabe an Fachpersonen. Für einen Gerätehersteller kann das erste Produkt ein wiederkehrendes Supportproblem einer Gerätefamilie abdecken.
Betrachten wir ein Liquid-Handling-Gerät, das einen unvollständigen Transfer meldet. Eine explizite Ablehnung vor der Ausführung und eine Zeitüberschreitung der Kommunikation nach dem Senden verlangen unterschiedliche Untersuchungen. Eine Aufzeichnung kann belegen, dass eine Softwareprüfung die Ausführung verhindert hat. Nach einer Zeitüberschreitung braucht der Assistent weitere Nachweise. Aus «keine Antwort empfangen» darf nicht «keine Bewegung erfolgt» werden.
Der Assistent kann diesen Unterschied erklären, die freigegebene Untersuchungsanleitung abrufen und die Aufzeichnungen für den Support zusammenstellen. Die Freigabe eines weiteren Transfers ist eine separate Fähigkeit. Unser Leitfaden zu KI-Assistenten und Agenten für Laborgeräte erläutert, wie Sie diese Produktgrenze festlegen.
Warum ein lokales LLM für nützlichen Support ausreichen kann
Einen dokumentierten Fehler zu erklären, nach einer fehlenden Softwareversion zu fragen und eine sachliche Zusammenfassung für den Support zu verfassen erfordert nicht grundsätzlich ein Frontier-Modell. Erforderlich sind die richtigen Informationen und ein Modell, das genau diese Aufgaben zuverlässig erledigt.
Geben Sie jeder Komponente eine klare Verantwortung. Die Suche findet anwendbares Wissen. Lesende Werkzeuge liefern Beobachtungen. Die Anwendungslogik ordnet Kennungen zu, prüft Berechtigungen und zeichnet Ausführungsergebnisse auf. Das Sprachmodell formt diesen Kontext zu einer Erklärung oder einer gezielten Rückfrage.
Lokale Inferenz lohnt sich als Prüfoption, wenn Dokumentation und Laufdaten vor Ort bleiben sollen oder der Support ohne externen Inferenzdienst arbeiten muss. «Lokal» kann einen Geräte-PC, einen Laborserver oder eine vom Hersteller verwaltete Installation bedeuten. Modellgrösse und Bereitstellungsort sind separate Entscheidungen; wählen Sie beides anhand der Hardware und Aufgabenanforderungen.
Die EffGen-Forschung von 2026 untersucht Aufgabenzerlegung, Kontextaufbereitung und Routing für Agenten mit kleinen Modellen. Sie stützt die Bewertung von Abläufen, die an Modellfähigkeiten ausgerichtet sind; eine Genauigkeit bei Laborgeräten belegt sie nicht.
Beginnen Sie mit dem kleinsten Modell, das Ihre Supportfälle bei akzeptabler Antwortzeit besteht. Schwierige Fälle können an Fachpersonen oder ein explizit erlaubtes leistungsfähigeres Modell gehen. Beziehen Sie Embedding-Inferenz, Dokumentverarbeitung und Telemetrie in die Bereitstellungsentscheidung ein: Ein lokales LLM allein legt nicht fest, wohin die übrigen Daten gelangen.
Die Architektur: Wissen, Beobachtungen und ein begrenzter Assistent
Freigegebene Handbücher, Versionshinweise, erlaubter Code und Gerätebeobachtungen bilden eine gemeinsame Grundlage. Verschiedene Assistenten können sie mit eigenen Aufgabenanweisungen, Zugriffsrechten und Abnahmekriterien nutzen.
Für den Assistenten bei gestoppten Läufen ist die Verarbeitungskette überschaubar:
- Den Fall zuordnen. Gerät, Softwareversion, Lauf und Symptom bestimmen. Fehlende Kennungen erfragen, bevor versionsspezifische Anleitungen ausgewählt werden.
- Anwendbares Wissen abrufen. Erklärung und freigegebene Untersuchungsanleitung finden; Quellenverweise und Warnungen erhalten.
- Verfügbare Nachweise lesen. Erlaubte Protokolle, Konfiguration und zeitgestempelten Status für diesen Fall sammeln.
- Die Antwort verfassen und prüfen. Nachweise erklären, Unsicherheit benennen und einen belegten nächsten Prüfschritt vorschlagen oder die Serviceübergabe vorbereiten.
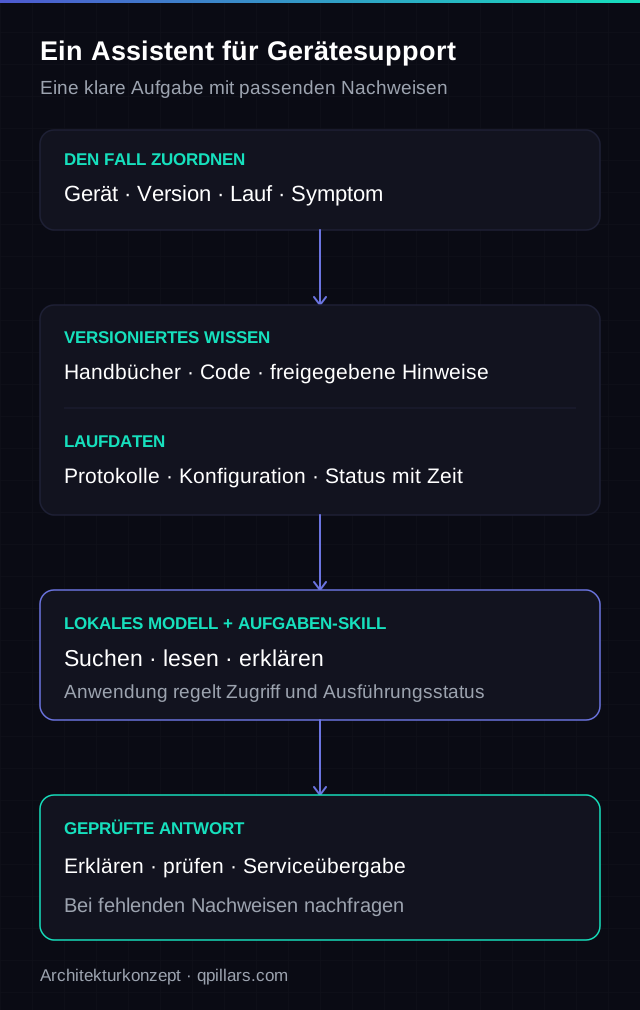
Ein graphbasierter Ablauf kann Suche, Werkzeugaufrufe und Rückfragen steuern. LangGraph ist eine Umsetzungsoption; entscheidend sind der Kontext pro Schritt und die Bedingungen für Antworten oder Eskalationen.
Handbücher und Code auffindbar machen
Retrieval-augmented Generation, kurz RAG, stellt relevantes Quellenmaterial im Arbeitskontext des Modells bereit. Gerätesupport braucht mehr Struktur als einen Ordner mit extrahiertem PDF-Text.
Erhalten Sie Überschriften, Seitenverweise und Warnungen. Prüfen Sie Tabellen und Abbildungen nach der Extraktion: Eine Anleitung kann ihren Sinn verlieren, wenn eine Warnung vom zugehörigen Schritt getrennt wird. Jede Passage braucht Gerätefamilie, anwendbare Versionen, Verbindlichkeit des Dokuments und Zugriffsregeln.
Wenn Quellcode verfügbar und dessen Nutzung erlaubt ist, indexieren Sie sinnvolle Einheiten wie Funktionen und Klassen mit ihren Symbolen und dem umgebenden Kontext. Syntaxbewusste Extraktion kann diese Grenzen erhalten. Code erklärt Softwareverhalten; den physischen Gerätezustand belegt er nicht eigenständig. Aktualisieren Sie den Index bei Änderungen freigegebener Dokumente oder Codeversionen und bewahren Sie die Version hinter jeder Antwort auf.
Embeddings helfen, verwandte Bedeutung zu finden. Ein Lauf, der «nach dem Senden eines Befehls hängen blieb», kann zu einer Anleitung über einen «unbestätigten Ausführungsausgang» passen. Exakte Suche bleibt für Fehlercodes, Befehlsnamen und Teilekennungen nützlich. Hybride Suche kombiniert diese Signale; Versions- und Berechtigungsfilter bestimmen, was zurückgegeben werden darf. Die Forschung zu Contextual Retrieval erklärt, weshalb der Kontext um Passagen erhalten bleiben sollte.
Dem Assistenten einen fokussierten Skill geben
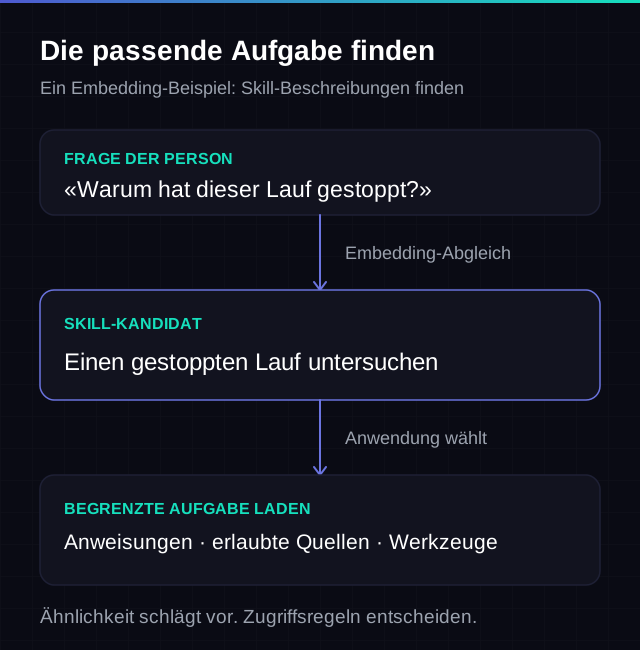
Ein Skill beschreibt, wann eine Aufgabe zutrifft, welche Nachweise anzufordern sind, welche Werkzeuge erlaubt sind und was eine zufriedenstellende Antwort enthält. Ein Skill «gestoppten Lauf untersuchen» könnte Laufkennung, anwendbare Anleitung und Ausführungsaufzeichnungen verlangen, bevor eine Erklärung verfasst wird.
Eine Embedding-Suche kann diesen Skill anhand der Formulierung vorschlagen. Die Anwendung lädt anschliessend seine Anweisungen und erlaubten Werkzeuge. Ähnlichkeit hilft beim Finden eines Kandidaten; sie gewährt keinen Zugriff und belegt keine Anwendbarkeit. Bei wenigen Aufgaben kann eine explizite Auswahl einfacher sein als semantisches Routing.
Vorhandene Protokolle nutzen und ihre Aussagekraft verstehen
Für den Einstieg müssen Sie das Protokollierungssystem eines Geräts nicht ersetzen. Bestehende Textprotokolle, exportierte Laufdaten oder eine freigegebene Status-API können Kontext liefern. Eine schlanke Normalisierungsschicht kann das ursprüngliche Ereignis zusammen mit Zeit, Quelle, Laufkennung, Befehl und gemeldetem Ergebnis erhalten.
Lässt sich ein Fehler dem richtigen Lauf zuordnen, eine abgelehnte Anfrage von einem unbekannten Ausgang unterscheiden und das Alter einer Statusbeobachtung bestimmen? Fehlende Nachweise werden zu einer konkreten Integrationsanforderung. OpenTelemetry kann beteiligte Softwarekomponenten korrelieren, aber ein nie aufgezeichnetes Geräteereignis nicht rekonstruieren.
Stellen Sie eng gefasste lesende Fähigkeiten bereit, etwa die Ereignisse eines Laufs abzurufen oder einen dokumentierten Fehler nachzuschlagen. Das Model Context Protocol für Laborgeräte kann eine gemeinsame Schnittstelle bieten. Berechtigungen und Befehlsbefugnis bleiben Verantwortung der Anwendung. Abgerufene Dokumente und Protokolle sind Nachweise und keine Anweisungen, die diese Verantwortung verändern dürfen.
Was uns die Implementierung über kleine Modelle gezeigt hat
In unserer Referenzimplementierung beantworteten ein CPU-lokales Granite-4.2-3B-Modell und gehostetes Claude Opus 5.5 beide sechs quellenbezogene Nachschlagefragen erfolgreich. Das lokale Modell machte zudem eine unbelegte Aussage bei einer von zwei Fragen, deren Antwort fehlte. In einer separaten, breiteren Gruppe von acht Supportaufgaben erledigte es 3/8 vollständig und das gehostete Modell 7/8.
Eine falsche Erklärung war mit einem echten Zitat versehen. Die technische Erkenntnis: Neben Quellenidentität und Ausgabeformat prüfen, ob die Quelle die Aussage stützt. Ein gültiger Quellenverweis kann einen falschen Schluss begleiten.
Die aufgezeichneten Ergebnisse, Beispiele und Methoden enthalten Fehler und den Vergleich mit direkten Quellenauszügen. Der Korpus bestand aus selbst verfassten Leitfäden, öffentlichem Code und synthetischen Aufzeichnungen, ohne angeschlossenes physisches Gerät. Bei der engeren Aufgabe änderten sich auch Suche und Antwortanforderungen. Diese Ergebnisse stützen eine aufgabenspezifische Bewertung; sie belegen weder Genauigkeit bei der Fehlersuche an Hardware noch Zeitersparnis.
Ein nützliches erstes Produkt für einen Gerätehersteller
Sichtbare Branchensignale für Geräteassistenten im Support gibt es. Tecan Introspect beschreibt agentische Empfehlungen aus Gerätedaten und lädt derzeit zum frühen Zugang ein. Der Nachhaltigkeitsbericht 2024 von Waters beschreibt einen internen Service Assistant für Expertenzentren und Servicetechniker im Aussendienst. Dies sind unterschiedliche Herstellerinitiativen und kein Beleg dafür, dass eine davon lokale Modelle nutzt.
Ein praktischer erster Lieferumfang ist eine Gerätefamilie, eine wiederkehrende Fehlerkategorie und ein lesender Assistent im bestehenden Supportweg. Legen Sie verbindliches Wissen, verfügbare Beobachtungen und Eskalationsbedingungen fest. Bewerten Sie anschliessend:
- Nutzen: Erreichen Bedienpersonen und Servicetechniker den nächsten passenden Prüfschritt leichter als mit reiner Dokumentensuche?
- Belegbarkeit: Folgt jede Erklärung aus den anwendbaren Quellen und den Nachweisen dieses Laufs?
- Unsicherheit: Fragt der Assistent fehlende Informationen ab und unterscheidet er bekannte Ergebnisse von unbekannten Ausgängen?
- Betrieb: Erfüllt die lokale Bereitstellung Anforderungen an Antwortzeit, Zugriff und Wartung?
Damit erhält das Modell eine nützliche, prüfbare Aufgabe: jemandem das gemeldete Geräteverhalten verständlich machen und die Untersuchung voranbringen.
QPillars entwickelt individuelle KI-Assistenten für Laborgeräte, die Gerätesoftware mit auffindbarem Wissen und begrenzten Abläufen verbinden. Bringen Sie ein wiederkehrendes Supportproblem mit, um eine fokussierte Umsetzung zu besprechen. Für Entwicklungsteams, die diese Fähigkeit aufbauen, bietet der Team-Workshop der Agentic Lab Academy einen praktischen Einstieg.
Technischer Leiter und Mitgründer bei QPillars
Spezialisiert auf Laborautomatisierung – von der praktischen Gerätesteuerung und Flüssigkeitshandhabung bis zur KI-gestützten Orchestrierung von Protokollen.